Стратегии join в Spark (Spark join strategies) выбираются по оценке размера таблиц, а эта оценка часто врёт. Инженер видит в плане SortMergeJoin там, где ждал broadcast, и не понимает, виновата ли статистика, тип join или подсказка. Ниже разбираем, как Spark принимает это решение и что меняет Adaptive Query Execution (AQE, адаптивное выполнение запросов). Утверждения популярной статьи сверяем с документацией и проверяем планами на открытом Spark в Docker, а не на Databricks.
Что говорит исходник
Статья Karan Pulyala Spark Join Strategies on Databricks построена вокруг одной мысли. Медленные задачи PySpark чаще всего медленны не из-за плохого кода, а потому, что Spark выбрал стратегию по неверной статистике. Умение читать физический план (physical plan) и объяснять, почему получился BroadcastHashJoin, а не SortMergeJoin, закрывает значительную долю проблем с производительностью.
Автор перечисляет три стратегии для equi-join (соединения по равенству ключей). Broadcast hash join (BHJ) не требует шафла, потому что маленькая сторона рассылается на все executor. Shuffle hash join (SHJ) шаффлит обе стороны, но не сортирует, и каждая партиция build side (стороны, из которой строится хеш-таблица) должна помещаться в память. Sort-merge join (SMJ) шаффлит и сортирует обе стороны и служит вариантом по умолчанию. Для non-equi join остаются broadcast nested loop join (BNLJ) и декартово произведение. Дальше идут порядок выбора, правило о том, какая сторона может быть build side, поведение AQE и приоритет подсказок.
Отдельный раздел исходника посвящён тому, как рассылка ломается. Автор называет нехватку памяти драйвера для «маленькой» таблицы, которая после распаковки оказалась большой, таймаут spark.sql.broadcastTimeout (300 секунд по умолчанию) и нагрузку на память executor, потому что копия есть у каждого. Он советует заранее оценивать размер рассылаемой стороны, держать статистику свежей через ANALYZE TABLE и учитывать, что cost-based optimizer переставляет многотабличные соединения только при наличии статистики по столбцам. В конце приведены вопросы для собеседования, а один из них про join по BETWEEN, который автор советует превращать в equi-join через бакеты диапазона. Этот приём мы проверяем в задании 3.
Исходник привязан к Databricks и заканчивается рекламой платного набора вопросов, эту часть мы не берём. Таблица допустимых build side по типам join и поведение local shuffle reader поданы в нём без ссылок на документацию. Поэтому мы сверяем текст с документацией Spark и проверяем спорное прогоном.
Как Spark выбирает стратегию и где здесь AQE
Документация по настройке производительности подтверждает главное. Порог spark.sql.autoBroadcastJoinThreshold по умолчанию равен 10 МБ, значение -1 отключает автоматический broadcast. Подсказка BROADCAST заставляет рассылать помеченную сторону независимо от этого порога. Оценка размера берётся из источника данных, из каталога после ANALYZE TABLE или считается на лету внутри AQE, и неточная статистика ухудшает план.
Порядок решений из исходника выглядит правдоподобно, но в документации в таком виде он не описан. Мы принимаем его как рабочую модель, а проверяем планами. Схема ниже показывает ветки, которые мы будем искать в выводе.
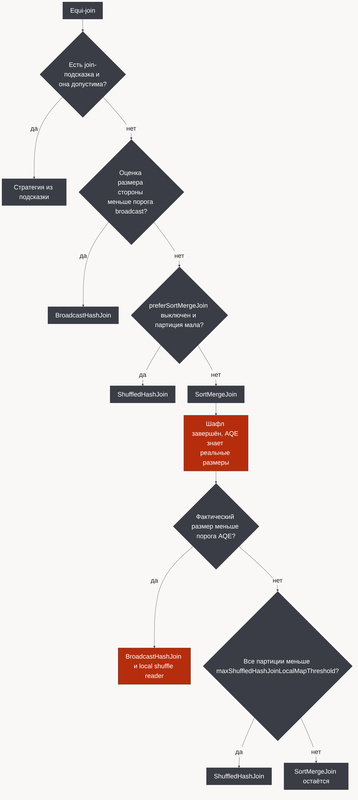
Подсказок четыре. Документация по hints задаёт приоритет BROADCAST, затем MERGE, затем SHUFFLE_HASH, затем SHUFFLE_REPLICATE_NL. Там же оговорено, что гарантии выбора нет, потому что стратегия может не поддерживать данный тип join. Если подсказка BROADCAST стоит на обеих сторонах, описание подсказки говорит, что рассылается меньшая сторона по статистике, и то же сказано про SHUFFLE_HASH на обеих сторонах. Общий абзац о приоритете на той же странице формулирует иначе, build side выбирается по типу join и размерам отношений. В нашем прогоне подсказка ставится только на одну сторону, поэтому эти формулировки он не сверяет.
Какая сторона может быть build side
Исходник утверждает, что для inner допустима любая сторона, для left, left_semi и left_anti только правая, для right только левая, а для full_outer broadcast hash join невозможен. В документации такой таблицы нет, там сказано лишь про отсутствие гарантий. Поэтому мы проверяем её на Spark 4.0.4 в задании 2. Для шести типов join из этого задания и обеих сторон подсказки результат прогона совпал с таблицей исходника. Другие типы, например right_semi, мы не проверяли.
Что AQE делает после шафла
AQE включён по умолчанию начиная со Spark 3.2.0, поэтому на открытом Spark его не нужно включать отдельно, в отличие от оговорки исходника про умолчание Databricks. По документации AQE превращает sort-merge join в broadcast hash join, если фактический размер любой стороны меньше spark.sql.adaptive.autoBroadcastJoinThreshold. Этот параметр по умолчанию наследует значение обычного порога. Документация называет такую замену менее эффективной, чем broadcast с самого начала, но лучшей, чем продолжение sort-merge join, потому что исчезает сортировка обеих сторон. При включённом spark.sql.adaptive.localShuffleReader.enabled shuffle-файлы читаются локально. Это ответ на вопрос о local shuffle reader, который в исходнике остался без ссылки.
Своё наблюдение за AQE мы берём из задания 1. До выполнения запрос печатается как AdaptiveSparkPlan isFinalPlan=false, а после collect тот же DataFrame печатается как isFinalPlan=true. В итоговом дереве рядом лежат разделы Final Plan и Initial Plan, а узлы обёрнуты в BroadcastQueryStage и ResultQueryStage. Итоговый план оказался равен начальному, замены стратегии не произошло. Прогон показал только оболочку AQE из стадий (QueryStage) и совпадение Initial Plan с Final Plan. Сценарий, ради которого автор вводит AQE, то есть замену SMJ на BHJ после шафла, наш пример не воспроизвёл, подробности в разборе задания 1.
Второе превращение ведёт в shuffled hash join. Документация уточняет то, чего нет в исходнике. Параметр spark.sql.adaptive.maxShuffledHashJoinLocalMapThreshold по умолчанию равен 0, и условие срабатывания двойное. Значение должно быть не меньше spark.sql.adaptive.advisoryPartitionSizeInBytes (по умолчанию 64 МБ), а все партиции не должны превышать порог. Тогда выбор shuffle hash join происходит независимо от spark.sql.join.preferSortMergeJoin. В шаге 5 прогона порог выставлен в 64 МБ, то есть равен advisory-размеру, а автоматический broadcast отключён. В видимой части вывода этого шага, где в плане агрегата с partial_count стоит SortMergeJoin Inner, ShuffledHashJoin не появился. Прогон показывает только этот результат и не объясняет, почему условие по партициям не выполнилось.
Третья функция AQE не про выбор стратегии, но влияет на то, что вы увидите в плане после шафла. По документации при включённых spark.sql.adaptive.enabled и spark.sql.adaptive.coalescePartitions.enabled Spark склеивает соседние маленькие партиции после шафла. Поэтому не нужно подбирать идеальное значение spark.sql.shuffle.partitions (по умолчанию 200), достаточно задать достаточно большое начальное число через spark.sql.adaptive.coalescePartitions.initialPartitionNum.
Сравнение стратегий
Мы свели в таблицу то, что подтверждено документацией, исходником или планами нашего прогона. Источник указан в ячейках, где он не очевиден.
| Стратегия | Шафл и сортировка | Когда применяется | Типичный риск | Параметр |
|---|---|---|---|---|
| BroadcastHashJoin | Шафла нет, маленькая сторона рассылается, сортировки нет | Одна сторона мала и может быть build side | Ошибка оценки размера и таймаут рассылки | spark. |
| ShuffledHashJoin | Шафл обеих сторон, сортировки нет | В AQE, когда все партиции не больше порога maxShuffledHashJoinLocal |
Партиция build side должна помещаться в память (исходник) | spark.sql.join. |
| SortMergeJoin | Шафл и сортировка обеих сторон (шаг 1 прогона) | Обе стороны велики, вариант по умолчанию | Стоимость шафла и сортировки | Отдельного нет, выбирается как запасной |
| Broadcast |
Рассылается одна сторона (шаг 6 прогона) | Нет equi-ключей, например BETWEEN | По словам автора исходника, превращает пятиминутную задачу в пятичасовую | Подсказки BROADCAST и SHUFFLE_REPLICATE_NL |
Времени выполнения мы не измеряли, наш прогон сравнивает только планы, поэтому выводы о стоимости опираются на документацию и исходник. BHJ избавляет от шафла, пока сторона мала, но зависит от оценки размера, а ошибка в ней ведёт либо к лишнему SMJ, либо к рассылке слишком большой таблицы. SMJ служит вариантом по умолчанию, и именно к нему Spark возвращается, когда другие условия не выполнены, как в шагах 1 и 3. Про SHJ документация сообщает, что порог для его выбора в AQE по умолчанию равен 0, поэтому без явной настройки он не включится. BNLJ нужен для условий без равенства, и здесь помогает не выбор стратегии, а переписывание условия, как в задании 3. Если нужен курс, где всё это разбирается системно вместе с планами запросов, посмотрите программу анализа данных со Spark SQL.
Практика, читаем планы на стенде
Стенд состоит из одного контейнера со Spark 4.0.4 в локальном режиме, порты наружу не публикуются, Spark UI отключён. Версия 4.0.4 выбрана потому, что именно этот образ доступен на нашем стенде. Данные генерируются при первом запуске. Таблица фактов содержит 3 000 000 строк, таблица измерений 1 000 000 строк со строковым столбцом из sha2, чтобы файл не сжимался до пары мегабайт. Обе пишутся в Parquet. Ссылки в статье ведут на документацию 4.3.0, а стенд работает на Spark 4.0.4. Поведение на 4.3.0 мы не проверяли, и параметры, помеченные в документации версиями 4.2.0 и 4.3.0, в примерах не используются.
# compose.yaml · Spark 4.0.4 · apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    entrypoint: ["sleep", "infinity"]
    mem_limit: 4g
    volumes:
      - ./:/work
Скрипт run.sh поднимает контейнер и запускает основной пример. Виртуальное окружение создаётся по правилам стенда, но сам код выполняется через spark-submit внутри контейнера, где PySpark уже есть.
# run.sh · Spark 4.0.4 · Docker Compose
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d
python3 -m venv .venv
.venv/bin/pip install --quiet "pyspark==4.0.4"
docker compose exec -T spark /opt/spark/bin/spark-submit /work/join_lab.py
Общий модуль lab_common.py создаёт сессию, генерирует таблицы и умеет возвращать текст плана. Для этого вывод метода explain перехватывается через redirect_stdout, потому что в PySpark он печатается средствами Python.
# lab_common.py · PySpark 4.0.4 · Spark 4.0.4
import contextlib
import glob
import io
import os
import re
import shutil

from pyspark.sql import SparkSession, functions as F

DATA = "/tmp/joinlab"
NODES = re.compile(
    r"(BroadcastHashJoin|SortMergeJoin|ShuffledHashJoin|BroadcastNestedLoopJoin|CartesianProduct)")


def _ensure_java():
    if os.environ.get("JAVA_HOME") or shutil.which("java"):
        if not os.environ.get("JAVA_HOME") and shutil.which("java"):
            real = os.path.realpath(shutil.which("java"))
            os.environ["JAVA_HOME"] = os.path.dirname(os.path.dirname(real))
        return
    for pattern in ("/usr/lib/jvm/*17*", "/usr/lib/jvm/*", "/opt/java/*"):
        for cand in sorted(glob.glob(pattern)):
            if os.path.exists(os.path.join(cand, "bin", "java")):
                os.environ["JAVA_HOME"] = cand
                os.environ["PATH"] = os.path.join(cand, "bin") + os.pathsep + os.environ.get("PATH", "")
                return


def get_spark(name):
    _ensure_java()
    spark = (SparkSession.builder.master("local[2]").appName(name)
             .config("spark.sql.shuffle.partitions", "8")
             .config("spark.ui.enabled", "false")
             .getOrCreate())
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def load_tables(spark):
    if not os.path.exists(DATA + "/dim"):
        fact = spark.range(3000000).select(
            F.col("id").alias("order_id"),
            (F.col("id") % 1000000).alias("customer_id"),
            (F.col("id") % 97).alias("amount"))
        dim = spark.range(1000000).select(
            F.col("id").alias("customer_id"),
            F.sha2(F.col("id").cast("string"), 256).alias("segment"))
        fact.write.mode("overwrite").parquet(DATA + "/fact")
        dim.write.mode("overwrite").parquet(DATA + "/dim")
    return spark.read.parquet(DATA + "/fact"), spark.read.parquet(DATA + "/dim")


def plan_text(df):
    buf = io.StringIO()
    with contextlib.redirect_stdout(buf):
        df.explain()
    return buf.getvalue()
Основной скрипт проходит шесть шагов. Сначала AQE и broadcast отключены, затем добавляется подсказка, затем left join с маленькой левой стороной. Четвёртый шаг включает AQE и фильтрует измерение до 1000 клиентов. Пятый задаёт порог для shuffled hash join. Шестой показывает join по BETWEEN. В шагах 4 и 5 мы вызываем collect на том же DataFrame, на котором потом вызываем explain, чтобы финальный план был виден в этом же объекте.
# join_lab.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F

from lab_common import get_spark, load_tables

spark = get_spark("join_lab")
fact, dim = load_tables(spark)


def section(title):
    print("\n=== " + title + " ===")


section("1. AQE выключен, broadcast выключен")
spark.conf.set("spark.sql.adaptive.enabled", "false")
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "-1")
fact.join(dim, "customer_id").explain()

section("2. Подсказка broadcast на dim")
fact.join(F.broadcast(dim), "customer_id").explain()

section("3. left join, маленькая сторона слева с подсказкой")
F.broadcast(dim).join(fact, "customer_id", "left").explain()

section("4. AQE включен, фильтр уменьшает dim")
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "10485760")
small = dim.filter(F.col("customer_id") < 1000)
result = fact.join(small, "customer_id")
print("--- до выполнения")
result.explain()
rows = result.collect()
print("строк в результате", len(rows))
print("--- после выполнения")
result.explain()

section("5. maxShuffledHashJoinLocalMapThreshold = 64 МБ")
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "-1")
spark.conf.set("spark.sql.adaptive.maxShuffledHashJoinLocalMapThreshold", "67108864")
agg = fact.join(dim, "customer_id").agg(F.count("*").alias("n"))
print(agg.collect())
agg.explain()

section("6. join по BETWEEN")
spark.conf.set("spark.sql.adaptive.enabled", "false")
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "10485760")
events = spark.range(200000).select(F.col("id").alias("ts"))
ranges = spark.range(100).select(
    (F.col("id") * 1000).alias("start"),
    (F.col("id") * 1000 + 1499).alias("end"),
    F.col("id").alias("rid"))
nl = events.join(ranges, (F.col("ts") >= F.col("start")) & (F.col("ts") <= F.col("end")))
nl.explain()
print("строк", nl.count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:08:18 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:08:18 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:08:18 INFO SparkContext: Java version 17.0.19
26/11/03 02:08:18 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".

=== 1. AQE выключен, broadcast выключен ===
== Physical Plan ==
*(5) Project [customer_id#1L, order_id#0L, amount#2L, segment#4]
+- *(5) SortMergeJoin [customer_id#1L], [customer_id#3L], Inner
   :- *(2) Sort [customer_id#1L ASC NULLS FIRST], false, 0
   :  +- Exchange hashpartitioning(customer_id#1L, 8), ENSURE_REQUIREMENTS, [plan_id=46]
   :     +- *(1) Filter isnotnull(customer_id#1L)
   :        +- *(1) ColumnarToRow
   :           +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>
   +- *(4) Sort [customer_id#3L ASC NULLS FIRST], false, 0
      +- Exchange hashpartitioning(customer_id#3L, 8), ENSURE_REQUIREMENTS, [plan_id=55]
         +- *(3) Filter isnotnull(customer_id#3L)
            +- *(3) ColumnarToRow
               +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [isnotnull(customer_id#3L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<customer_id:bigint,segment:string>


=== 2. Подсказка broadcast на dim ===
== Physical Plan ==
*(2) Project [customer_id#1L, order_id#0L, amount#2L, segment#4]
+- *(2) BroadcastHashJoin [customer_id#1L], [customer_id#3L], Inner, BuildRight, false
   :- *(2) Filter isnotnull(customer_id#1L)
   :  +- *(2) ColumnarToRow
   :     +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>
   +- BroadcastExchange HashedRelationBroadcastMode(List(input[0, bigint, false]),false), [plan_id=121]
      +- *(1) Filter isnotnull(customer_id#3L)
         +- *(1) ColumnarToRow
            +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [isnotnull(customer_id#3L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<customer_id:bigint,segment:string>


=== 3. left join, маленькая сторона слева с подсказкой ===
== Physical Plan ==
*(5) Project [customer_id#3L, segment#4, order_id#0L, amount#2L]
+- *(5) SortMergeJoin [customer_id#3L], [customer_id#1L], LeftOuter
   :- *(2) Sort [customer_id#3L ASC NULLS FIRST], false, 0
   :  +- Exchange hashpartitioning(customer_id#3L, 8), ENSURE_REQUIREMENTS, [plan_id=173]
   :     +- *(1) ColumnarToRow
   :        +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [], ReadSchema: struct<customer_id:bigint,segment:string>
   +- *(4) Sort [customer_id#1L ASC NULLS FIRST], false, 0
      +- Exchange hashpartitioning(customer_id#1L, 8), ENSURE_REQUIREMENTS, [plan_id=182]
         +- *(3) Filter isnotnull(customer_id#1L)
            +- *(3) ColumnarToRow
               +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>

… (пропущено строк: 80)
   +- Exchange SinglePartition, ENSURE_REQUIREMENTS, [plan_id=378]
      +- HashAggregate(keys=[], functions=[partial_count(1)])
         +- Project
            +- SortMergeJoin [customer_id#1L], [customer_id#3L], Inner
               :- Sort [customer_id#1L ASC NULLS FIRST], false, 0
               :  +- Exchange hashpartitioning(customer_id#1L, 8), ENSURE_REQUIREMENTS, [plan_id=370]
               :     +- Filter isnotnull(customer_id#1L)
               :        +- FileScan parquet [customer_id#1L] Batched: true, DataFilters: [isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<customer_id:bigint>
               +- Sort [customer_id#3L ASC NULLS FIRST], false, 0
                  +- Exchange hashpartitioning(customer_id#3L, 8), ENSURE_REQUIREMENTS, [plan_id=371]
                     +- Filter isnotnull(customer_id#3L)
                        +- FileScan parquet [customer_id#3L] Batched: true, DataFilters: [isnotnull(customer_id#3L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id)], ReadSchema: struct<customer_id:bigint>


=== 6. join по BETWEEN ===
== Physical Plan ==
*(2) BroadcastNestedLoopJoin BuildRight, Inner, ((ts#16L >= start#18L) AND (ts#16L <= end#19L))
:- *(2) Project [id#15L AS ts#16L]
:  +- *(2) Range (0, 200000, step=1, splits=2)
+- BroadcastExchange IdentityBroadcastMode, [plan_id=538]
   +- *(1) Project [(id#17L * 1000) AS start#18L, ((id#17L * 1000) + 1499) AS end#19L, id#17L AS rid#20L]
      +- *(1) Range (0, 100, step=1, splits=2)


строк 150000
Что показал прогон. В шаге 1 при выключенных AQE и broadcast получился SortMergeJoin с Sort и Exchange hashpartitioning по обеим сторонам, то есть полный шафл и сортировка. В шаге 2 подсказка на измерении дала BroadcastHashJoin с BuildRight и BroadcastExchange над таблицей dim, а Exchange и Sort исчезли. В шаге 3 подсказка broadcast на левой стороне left join проигнорирована, план остался SortMergeJoin LeftOuter с шафлом обеих сторон и без BroadcastExchange. Это ровно тот случай, о котором предупреждает исходник, и подробнее его разбирает задание 2. В видимой части вывода шага 5, где в плане агрегата с partial_count стоит SortMergeJoin Inner, ShuffledHashJoin не появился. Начало вывода этого шага в показанном фрагменте пропущено, поэтому мы опираемся только на видимый план. В шаге 6 для условия BETWEEN выбран BroadcastNestedLoopJoin BuildRight, результат содержит 150 000 строк. Поведение AQE мы смотрим на плане задания 1, потому что он выводится целиком.
Задания
Каждое решение запускается на том же стенде командой spark-submit внутри контейнера и использует lab_common.py.
Задание 1. Что оценил оптимизатор и кто стал build side
Отфильтруйте измерение до 1000 клиентов, выставьте порог вдвое ниже оценки оптимизатора и сравните начальный и итоговый планы AQE. Определите, какая сторона стала build side, и скажите, что прогон говорит о сценарии замены SortMergeJoin на BroadcastHashJoin.
Решение
Читаем оценку размера отфильтрованного измерения из оптимизатора и ставим порог в половину этой оценки. Скрипт печатает оценку, порог, начальный и итоговый планы.
# task1_aqe_switch.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F

from lab_common import get_spark, load_tables

spark = get_spark("task1")
fact, dim = load_tables(spark)
spark.conf.set("spark.sql.adaptive.enabled", "true")

small = dim.filter(F.col("customer_id") < 1000)
est = int(str(small._jdf.queryExecution().optimizedPlan().stats().sizeInBytes()))
threshold = est // 2
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", str(threshold))
print("оценка размера dim, байт", est, "порог", threshold)

result = fact.join(small, "customer_id")
print("--- начальный план")
result.explain()
print("строк", len(result.collect()))
print("--- итоговый план")
result.explain()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:08:35 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:08:35 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:08:35 INFO SparkContext: Java version 17.0.19
26/11/03 02:08:35 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
оценка размера dim, байт 70124035 порог 35062017
--- начальный план
== Physical Plan ==
AdaptiveSparkPlan isFinalPlan=false
+- Project [customer_id#1L, order_id#0L, amount#2L, segment#4]
   +- BroadcastHashJoin [customer_id#1L], [customer_id#3L], Inner, BuildLeft, false
      :- BroadcastExchange HashedRelationBroadcastMode(List(input[1, bigint, false]),false), [plan_id=26]
      :  +- Filter ((customer_id#1L < 1000) AND isnotnull(customer_id#1L))
      :     +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [(customer_id#1L < 1000), isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [LessThan(customer_id,1000), IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>
      +- Filter (isnotnull(customer_id#3L) AND (customer_id#3L < 1000))
         +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [isnotnull(customer_id#3L), (customer_id#3L < 1000)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id), LessThan(customer_id,1000)], ReadSchema: struct<customer_id:bigint,segment:string>


строк 3000
--- итоговый план
== Physical Plan ==
AdaptiveSparkPlan isFinalPlan=true
+- == Final Plan ==
   ResultQueryStage 1
   +- *(2) Project [customer_id#1L, order_id#0L, amount#2L, segment#4]
      +- *(2) BroadcastHashJoin [customer_id#1L], [customer_id#3L], Inner, BuildLeft, false
         :- BroadcastQueryStage 0
         :  +- BroadcastExchange HashedRelationBroadcastMode(List(input[1, bigint, false]),false), [plan_id=40]
         :     +- *(1) Filter ((customer_id#1L < 1000) AND isnotnull(customer_id#1L))
         :        +- *(1) ColumnarToRow
         :           +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [(customer_id#1L < 1000), isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [LessThan(customer_id,1000), IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>
         +- *(2) Filter (isnotnull(customer_id#3L) AND (customer_id#3L < 1000))
            +- *(2) ColumnarToRow
               +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [isnotnull(customer_id#3L), (customer_id#3L < 1000)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id), LessThan(customer_id,1000)], ReadSchema: struct<customer_id:bigint,segment:string>
+- == Initial Plan ==
   Project [customer_id#1L, order_id#0L, amount#2L, segment#4]
   +- BroadcastHashJoin [customer_id#1L], [customer_id#3L], Inner, BuildLeft, false
      :- BroadcastExchange HashedRelationBroadcastMode(List(input[1, bigint, false]),false), [plan_id=26]
      :  +- Filter ((customer_id#1L < 1000) AND isnotnull(customer_id#1L))
      :     +- FileScan parquet [order_id#0L,customer_id#1L,amount#2L] Batched: true, DataFilters: [(customer_id#1L < 1000), isnotnull(customer_id#1L)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/fact], PartitionFilters: [], PushedFilters: [LessThan(customer_id,1000), IsNotNull(customer_id)], ReadSchema: struct<order_id:bigint,customer_id:bigint,amount:bigint>
      +- Filter (isnotnull(customer_id#3L) AND (customer_id#3L < 1000))
         +- FileScan parquet [customer_id#3L,segment#4] Batched: true, DataFilters: [isnotnull(customer_id#3L), (customer_id#3L < 1000)], Format: Parquet, Location: InMemoryFileIndex(1 paths)[file:/tmp/joinlab/dim], PartitionFilters: [], PushedFilters: [IsNotNull(customer_id), LessThan(customer_id,1000)], ReadSchema: struct<customer_id:bigint,segment:string>
Результат оказался не тем, что описывает исходник. Оптимизатор оценил измерение после фильтра в 70 124 035 байт, а в самом измерении после фильтра 1000 клиентов. Порог 35 062 017 байт ниже этой оценки, но начальный план всё равно BroadcastHashJoin, а не SortMergeJoin. Build side помечен BuildLeft, и под BroadcastExchange стоит не измерение, а таблица фактов с фильтром customer_id < 1000, который Spark перенёс на неё через равенство ключей. Оценку размера отфильтрованной таблицы фактов скрипт не печатал, поэтому почему именно эта сторона прошла порог, прогон не доказывает. Можно предположить, что её оценка оказалась ниже порога, но это предположение. Итоговый план после collect тоже BroadcastHashJoin BuildLeft и совпадает с разделом Initial Plan. Замены SortMergeJoin на BroadcastHashJoin внутри AQE в этом прогоне не было, и прогон её не показывает. Результат содержит 3000 строк.
Задание 2. Матрица типов join и подсказок
Для типов inner, left, right, left_semi, left_anti и full_outer поставьте подсказку broadcast сначала на левую, потом на правую сторону. Определите фактическую стратегию по плану и объясните, почему часть подсказок игнорируется.
Решение
Строим планы без выполнения, AQE выключен, автоматический broadcast отключён, поэтому любой BroadcastHashJoin в выводе появляется только из подсказки. В колонке build указана сторона из плана, если узел её называет.
# task2_matrix.py · PySpark 4.0.4 · Spark 4.0.4
import re

from pyspark.sql import functions as F

from lab_common import NODES, get_spark, load_tables, plan_text

spark = get_spark("task2")
fact, dim = load_tables(spark)
spark.conf.set("spark.sql.adaptive.enabled", "false")
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "-1")

left = fact.select("customer_id", "order_id")
right = dim.select("customer_id", "segment")

print("join       hint   node                    build")
for jt in ["inner", "left", "right", "left_semi", "left_anti", "full_outer"]:
    for side in ("left", "right"):
        l = F.broadcast(left) if side == "left" else left
        r = F.broadcast(right) if side == "right" else right
        text = plan_text(l.join(r, "customer_id", jt))
        nodes = NODES.findall(text)
        node = nodes[0] if nodes else "-"
        m = re.search(r"Build(Left|Right)", text)
        build = m.group(0) if m else "-"
        print(jt.ljust(10), side.ljust(6), node.ljust(23), build)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:08:48 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:08:48 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:08:48 INFO SparkContext: Java version 17.0.19
26/11/03 02:08:48 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
join       hint   node                    build
inner      left   BroadcastHashJoin       BuildLeft
inner      right  BroadcastHashJoin       BuildRight
left       left   SortMergeJoin           -
left       right  BroadcastHashJoin       BuildRight
right      left   BroadcastHashJoin       BuildLeft
right      right  SortMergeJoin           -
left_semi  left   SortMergeJoin           -
left_semi  right  BroadcastHashJoin       BuildRight
left_anti  left   SortMergeJoin           -
left_anti  right  BroadcastHashJoin       BuildRight
full_outer left   SortMergeJoin           -
full_outer right  SortMergeJoin           -
Таблица показала для этих шести типов join то же, что утверждает исходник. Для inner подсказка принимается с любой стороны, получаются BuildLeft и BuildRight. Для left, left_semi и left_anti BroadcastHashJoin возникает только при подсказке на правой стороне (BuildRight), а подсказка на левой игнорируется и остаётся SortMergeJoin. Для right всё наоборот, подсказка на левой стороне даёт BuildLeft, на правой остаётся SortMergeJoin. Для full_outer в этом прогоне обе подсказки проигнорированы. Объяснение причины не следует из прогона, это общеизвестное поведение. Сторону, все строки которой нужно сохранить, нельзя сделать build side, потому что по хеш-таблице из неё не найти строки без пары. Документация формулирует это только общей оговоркой, что стратегия может не поддерживать данный тип join.
Задание 3. BETWEEN и бакеты
Перепишите join по BETWEEN на equi-join с бакетами диапазона и фильтром. Сравните планы и убедитесь, что количество строк и контрольная сумма совпадают.
Решение
Каждый диапазон раскладываем по бакетам шириной 500 через sequence и explode. Событие попадает ровно в один бакет, поэтому после фильтра по границам каждая пара событие и диапазон встречается один раз, и результат должен совпасть с исходным. Совпадение скрипт проверяет сам.
# task3_buckets.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F

from lab_common import NODES, get_spark, plan_text

spark = get_spark("task3")
spark.conf.set("spark.sql.adaptive.enabled", "false")

B = 500
events = spark.range(200000).select(F.col("id").alias("ts"))
ranges = spark.range(100).select(
    (F.col("id") * 1000).alias("start"),
    (F.col("id") * 1000 + 1499).alias("end"),
    F.col("id").alias("rid"))

cond = (F.col("ts") >= F.col("start")) & (F.col("ts") <= F.col("end"))
nested = events.join(ranges, cond)

exploded = ranges.select(
    "rid", "start", "end",
    F.explode(F.sequence(F.floor(F.col("start") / B), F.floor(F.col("end") / B))).alias("bucket"))
keyed = events.withColumn("bucket", F.floor(F.col("ts") / B))
bucketed = keyed.join(exploded, "bucket").filter(cond)


def summary(df):
    row = df.agg(F.count("*").alias("n"), F.sum(F.col("ts") + F.col("rid")).alias("s")).first()
    return row["n"], row["s"]


print("nested  ", NODES.findall(plan_text(nested)))
print("bucketed", NODES.findall(plan_text(bucketed)))
a, b = summary(nested), summary(bucketed)
print("nested  count/sum", a)
print("bucketed count/sum", b)
print("совпадают", a == b)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:08:59 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:08:59 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:08:59 INFO SparkContext: Java version 17.0.19
26/11/03 02:08:59 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
nested   ['BroadcastNestedLoopJoin']
bucketed ['BroadcastHashJoin']
nested  count/sum (150000, 7544850000)
bucketed count/sum (150000, 7544850000)
совпадают True
Исходное условие даёт BroadcastNestedLoopJoin, переписанное через бакеты даёт BroadcastHashJoin. Число строк (150 000) и контрольная сумма (7 544 850 000) у двух вариантов совпали. Времени выполнения мы не замеряли, поэтому выигрыш в скорости этот прогон не доказывает, он показывает только смену стратегии при том же результате.
Если вы хотите научиться читать планы Spark SQL так же уверенно и разбирать AQE, статистику и подсказки на своих данных, загляните на курс Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX.
Референсные ссылки
- Karan Pulyala, Spark Join Strategies on Databricks — исходная статья.
- Spark SQL, Performance Tuning — пороги broadcast, AQE, конвертация SMJ в BHJ и SHJ.
- Spark SQL, Hints — join-подсказки и их приоритет.