Spark vs DuckDB single node benchmark выглядит простым сравнением, пока не начинаешь разбирать, что именно измерили. Недавно на Medium вышел разбор от Intellytics Solutions, где один и тот же запрос на 100 ГБ Parquet прогнали через Spark на кластере EMR, через DuckDB и через DataFusion. Вывод у автора громкий, одна машина выигрывает и по времени, и по стоимости. Здесь мы разберём, что из этого следует, а что нет, и воспроизведём замер в миниатюре на одинаковых ядрах одного контейнера.
О чём бенчмарк на 100 ГБ и что он не доказывает
В исходной статье задача типовая. Большая таблица финансовых транзакций соединяется с небольшим справочником мерчантов, фильтруется по одному региону и агрегируется по категориям. Автор приводит для Spark около 842 секунд и говорит, что DuckDB оказался примерно в 9 раз быстрее и примерно в 26 раз дешевле по вычислениям, а DataFusion отстал от него совсем немного.
Главная мысль автора верна и без цифр. У распределённого исполнения есть фиксированная цена. Нужно запустить контейнеры исполнителей (executors), сериализовать промежуточные данные, переслать их по сети и управлять памятью в каждом исполнителе. На данных в десятки и сотни гигабайт эта цена может быть больше самой работы. Современный сервер с десятками ядер и сотнями гигабайт памяти обрабатывает такой объём вообще без кластера.
Но сам автор честно перечисляет ограничения. Кластер Spark в этом замере имел вдвое больше vCPU и в восемь раз больше памяти, чем одиночная машина, так что сравнение шло не на одном железе. Число партиций shuffle осталось по умолчанию, то есть 200. В расчёт стоимости не вошла надбавка EMR. Наконец, в четыре минуты ожидания Spark вошли запуск кластера и контейнеров, а это издержки инфраструктуры, а не движка. Сам автор предлагает добавить контрольный прогон Spark в режиме local[*] на той же машине. Этот прогон мы и сделаем, только в миниатюре.
Наш стенд не воспроизводит 100 ГБ и не проверяет числа исходника. Он показывает механизм, то есть откуда берутся накладные расходы Spark, как они зависят от настроек и где у DuckDB наступает предел памяти. Для инженера это полезнее, чем ещё одна цифра с чужого железа.
Откуда берётся разница между Spark и DuckDB
Разница складывается из нескольких независимых вещей. Если не разделять их, легко сделать неверный вывод вроде «JVM медленная» или «DuckDB всегда лучше». Начнём со стороны Spark, потому что именно здесь меняется больше всего, если подкрутить настройки.
Старт, shuffle и broadcast join в Spark
Первое слагаемое это старт. Процесс драйвера, планирование, запуск задач и, на кластере, контейнеры исполнителей появляются до того, как прочитан первый байт данных. В режиме local[*] кластерной части нет, но JVM и сессия всё равно стартуют заметно дольше, чем встроенная библиотека. Мы измеряем импорт и создание сессии отдельно от времени запроса, но этот показатель неполный, и ниже мы объясним почему.
Второе слагаемое это shuffle, то есть перераспределение данных между задачами по ключу. Он включает сериализацию, запись на локальный диск, сетевую выборку и десериализацию. Единственный процесс DuckDB обходится без такого шага, потому что все потоки видят одну и ту же память. В Spark число партиций после shuffle задаёт параметр spark.sql.shuffle.partitions, по умолчанию 200. На маленьком наборе 200 крошечных задач означают, что планировщик тратит время на сами задачи, а не на данные.
Третье слагаемое это стратегия join. Если справочник мерчантов маленький, его можно разослать всем задачам целиком (broadcast join), и тогда большая таблица вообще не участвует в shuffle на стадии соединения. Порог автоматического выбора задаёт spark.sql.autoBroadcastJoinThreshold, по документации 10 МБ по умолчанию, значение -1 выключает рассылку. Подсказка broadcast в коде перекрывает порог, поэтому в исходнике сравнение сделано честно именно через неё.
Четвёртое слагаемое это адаптивное выполнение запросов (Adaptive Query Execution, AQE). Оно включено по умолчанию начиная со Spark 3.2.0 и пересматривает план по реальной статистике во время работы. В частности, оно умеет объединять мелкие партиции после shuffle и превращать sort-merge join в broadcast hash join. Поэтому разрыв между «200 партиций» и «8 партиций» на практике зависит ещё и от того, включён ли AQE, и это мы проверим в заданиях. Подробнее механику Spark на уровне RDD и планировщика разбирает курс Основы Apache Spark для разработчиков и аналитиков.
Отдельно отметим, что Spark далеко не наивен. Tungsten хранит данные в компактном бинарном виде, генерирует код для целых стадий, а чтение Parquet по умолчанию векторизовано, с пакетом в 4096 строк на батч согласно параметру spark.sql.parquet.columnarReaderBatchSize. Поэтому слова «JVM медленная» объясняют мало. Ощутимее расходы на границах, то есть на shuffle и на передачу данных между JVM и Python.
Векторизация и spill в DuckDB
DuckDB это встраиваемая аналитическая СУБД на C++ с собственным колоночным векторизованным движком. Она обрабатывает данные порциями, стандартный вектор содержит 2048 значений, и операторы вроде фильтра по региону превращаются в тугие циклы по непрерывным массивам. Такие циклы хорошо ложатся на кэши процессора и инструкции SIMD. Исходник честно напоминает, что Parquet при этом не zero-copy. Файл нужно прочитать, распаковать и декодировать, поэтому значительная часть времени на скане уходит именно на декодирование, а польза от обмена буферами начинается только после него.
Платой за встроенность становится конечная память и единый домен отказа. Когда запрос не помещается в memory_limit, DuckDB умеет сбрасывать промежуточное состояние хеш-соединений, сортировок и агрегаций во временный каталог. Каталог задаёт temp_directory. Но не каждый оператор поддерживает такой сброс, и при слишком малом лимите запрос может завершиться ошибкой нехватки памяти. Если процесс умирает, задача начинается с нуля, если вы сами не делали контрольных точек. Spark же повторяет упавшие задачи и переживает потерю узла, и ради этого его накладные расходы часто оправданы.
Документация DuckDB называет последним стабильным выпуском Python-клиента 2.0.0 и требует Python 3.11 или новее. Наш стенд работает на Python из образа Spark, поэтому мы закрепили версию 1.5.6 в run.sh, и все замеры ниже относятся именно к ней. Настройки передаются через SET или прямо в соединение через duckdb.connect(config={…}). Так мы ограничиваем потоки и память, чтобы сравнивать движки на равных.
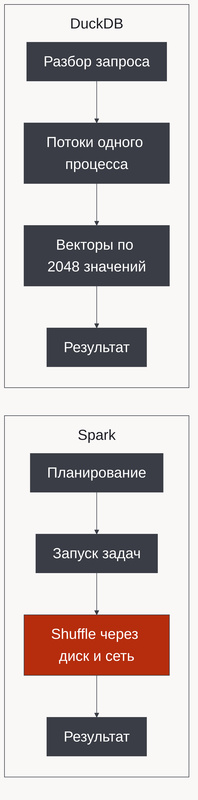
Таблица сравнения Spark и DuckDB
Прежде чем идти на стенд, сведём в одну таблицу то, что известно из исходника и документации. Режим Spark local[*] вынесен отдельным столбцом, потому что он ведёт себя как одиночный процесс и именно он нужен для честного сравнения с DuckDB. DataFusion в таблицу не включён, потому что на нашем стенде мы его не запускали.
| Критерий | Spark на кластере | Spark local[*] | DuckDB |
|---|---|---|---|
| Модель исполнения | Распределённая, JVM, Tungsten и векторизованное чтение Parquet | Тот же движок в одном процессе JVM | Встроенный процесс, колоночные векторы по 2048 значений |
| Масштабирование | Вширь, добавлением узлов | Только вверх, по ядрам и памяти | Только вверх |
| Отказоустойчивость | Повтор упавших задач, переживает потерю узла | Один процесс, один домен отказа | Один домен отказа, перезапуск с начала |
| Сброс на диск | Сбрасывает shuffle и агрегации на локальный диск | Так же, на локальный диск | Сбрасывает на диск при превышении memory_limit, каталог задаёт temp_directory |
| Стоимость запуска | Запуск кластера и контейнеров, минуты | Запуск JVM и сессии | Импорт библиотеки |
| Подходящий объём | Данные и промежуточные результаты больше одной машины | То, что помещается на одну машину | От гигабайт до нескольких сотен гигабайт на одном узле |
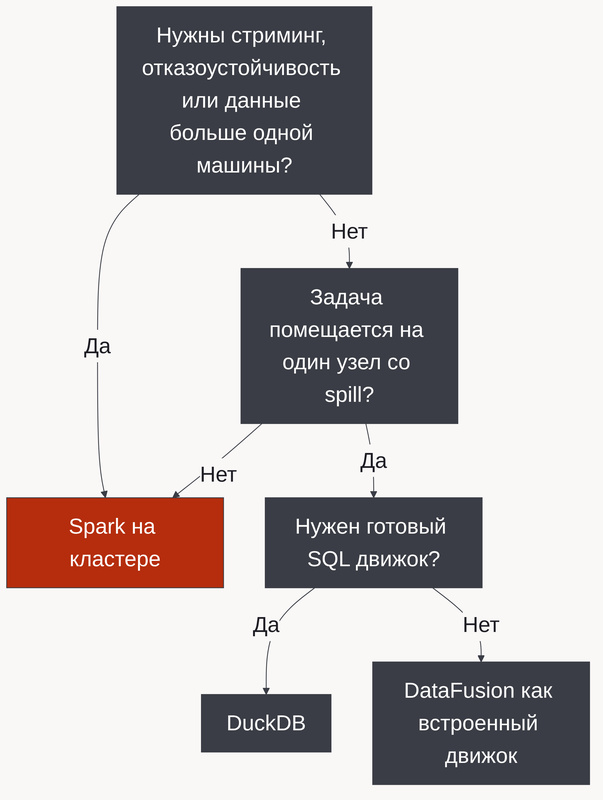
Таблица показывает, что выбор идёт не по скорости, а по форме задачи. Если нужны потоковая обработка, автоматическое восстановление после падения узла или данные, которые физически не помещаются на одну машину, у Spark на кластере нет замены. Если задача помещается на узел и нужен готовый SQL, DuckDB выигрывает старт и простоту эксплуатации.
Практика. Один запрос на одинаковых ресурсах
Стенд состоит из одного контейнера со Spark 4.0.4 и лимитом памяти 6 ГБ. DuckDB мы ставим в тот же контейнер через pip в каталог /tmp/pylibs, потому что на хосте нет ни Java, ни нужды в pip, а общий контейнер даёт обоим движкам одни и те же ядра и один диск. Для честности зафиксируем условия. Оба движка работают на 4 потоках, Spark запускается как local[4], а DuckDB получает threads равный 4. Память строго не выравнивалась. DuckDB ограничен memory_limit в 1 ГБ, а Spark работает с настройками памяти по умолчанию, поэтому сравнение по памяти приблизительное.
Файл compose.yaml описывает единственный сервис. Он держится командой sleep infinity, а код монтируется с хоста только на чтение.
# compose.yaml · apache/spark 4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    command: ["sleep", "infinity"]
    mem_limit: 6g
    volumes:
      - ./:/work:ro
Скрипт run.sh поднимает стенд, ставит duckdb в /tmp/pylibs и запускает основной пример. Решения заданий он не трогает.
#!/usr/bin/env bash
# run.sh · Docker Compose · Spark 4.0.4 · duckdb 1.5.6
set -euo pipefail
docker compose up -d --wait
docker compose exec -T spark python3 -m pip install --quiet --no-cache-dir --target /tmp/pylibs duckdb==1.5.6
SUBMIT="/opt/spark/bin/spark-submit --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false"
docker compose exec -T spark $SUBMIT /work/gen_data.py
docker compose exec -T spark $SUBMIT /work/spark_job.py
docker compose exec -T spark $SUBMIT /work/duck_job.py
Данные генерирует Spark. Факт-таблица содержит 30 миллионов транзакций с регионом, идентификатором мерчанта и суммой в целых центах. Целые числа нужны, чтобы суммы в обоих движках совпали точно и не зависели от порядка сложения чисел с плавающей точкой. Справочник содержит 10 тысяч мерчантов, распределённых по 50 категориям.
# gen_data.py · Spark 4.0.4 · Python 3
from pyspark.sql import SparkSession
import pyspark.sql.functions as F

spark = SparkSession.builder.appName("gen_data").master("local[4]").getOrCreate()
spark.sparkContext.setLogLevel("WARN")

N = 30_000_000
transactions = spark.range(N).select(
    F.col("id").alias("txn_id"),
    F.expr("element_at(array('EMEA','APAC','AMER','LATAM','MEA'), cast(pmod(id * 7, 5) as int) + 1)").alias("region"),
    F.expr("cast(pmod(id * 2654435761, 10000) as int)").alias("merchant_id"),
    F.expr("pmod(id * 31, 100000)").alias("amount"),
)
transactions.repartition(8).write.mode("overwrite").parquet("/tmp/bench/transactions")

merchants = spark.range(10000).select(
    F.col("id").cast("int").alias("merchant_id"),
    F.concat(F.lit("cat_"), F.expr("cast(pmod(id, 50) as string)")).alias("merchant_category"),
)
merchants.coalesce(1).write.mode("overwrite").parquet("/tmp/bench/merchants")

print("transactions", spark.read.parquet("/tmp/bench/transactions").count())
print("merchants", spark.read.parquet("/tmp/bench/merchants").count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:35:18 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:35:18 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:35:18 INFO SparkContext: Java version 17.0.19
26/11/04 18:35:18 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
transactions 30000000
merchants 10000
Теперь запрос в Spark. Он повторяет логику исходника, то есть фильтр по региону EMEA, явный broadcast справочника и агрегацию по категории. Запрос выполняется дважды, потому что первый запуск включает прогрев JVM и чтение метаданных, а второй показывает установившееся время. Показатель startup_s считает импорт pyspark и создание сессии. Сам запуск JVM командой spark-submit в него не входит.
# spark_job.py · Spark 4.0.4 · Python 3
import time
T0 = time.perf_counter()
from pyspark.sql import SparkSession
import pyspark.sql.functions as F

spark = SparkSession.builder.appName("spark_job").master("local[4]").getOrCreate()
spark.sparkContext.setLogLevel("WARN")
startup = time.perf_counter() - T0

transactions = spark.read.parquet("/tmp/bench/transactions")
merchants = spark.read.parquet("/tmp/bench/merchants")


def query():
    return (
        transactions.filter(F.col("region") == "EMEA")
        .join(F.broadcast(merchants), "merchant_id")
        .groupBy("merchant_category")
        .agg(F.sum("amount").alias("total_amount"), F.avg("amount").alias("avg_amount"))
    )


print(f"startup_s={startup:.2f}")
for i in (1, 2):
    t = time.perf_counter()
    rows = query().orderBy("merchant_category").collect()
    print(f"run={i} query_s={time.perf_counter() - t:.2f}")

print("categories", len(rows))
print("total_sum", sum(r["total_amount"] for r in rows))
for r in rows[:3]:
    print(r["merchant_category"], r["total_amount"], round(r["avg_amount"], 2))
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:36:07 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:36:07 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:36:07 INFO SparkContext: Java version 17.0.19
26/11/04 18:36:07 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
startup_s=5.11
run=1 query_s=7.24
run=2 query_s=3.52
categories 10
total_sum 299985000000
cat_0 29985000000 49975.0
cat_10 29991000000 49985.0
cat_15 29994000000 49990.0
Тот же запрос в DuckDB написан на чистом SQL и читает те же Parquet-файлы напрямую. Скрипт запускается через spark-submit только потому, что так раннер запускает все файлы стенда. Время мы считаем внутри Python-процесса, поэтому JVM, которую поднимает spark-submit, в замер не попадает.
# duck_job.py · duckdb 1.5.6 · Python 3
import sys
import time
sys.path.insert(0, "/tmp/pylibs")
T0 = time.perf_counter()
import duckdb

con = duckdb.connect()
con.execute("SET threads = 4")
con.execute("SET memory_limit = '1GB'")
startup = time.perf_counter() - T0

QUERY = """
SELECT m.merchant_category,
       SUM(t.amount) AS total_amount,
       AVG(t.amount) AS avg_amount
FROM read_parquet('/tmp/bench/transactions/*.parquet') t
JOIN read_parquet('/tmp/bench/merchants/*.parquet') m ON t.merchant_id = m.merchant_id
WHERE t.region = 'EMEA'
GROUP BY m.merchant_category
ORDER BY m.merchant_category
"""

print(f"startup_s={startup:.2f}")
for i in (1, 2):
    t = time.perf_counter()
    rows = con.execute(QUERY).fetchall()
    print(f"run={i} query_s={time.perf_counter() - t:.2f}")

print("categories", len(rows))
print("total_sum", sum(r[1] for r in rows))
for r in rows[:3]:
    print(r[0], r[1], round(r[2], 2))
WARNING: Using incubator modules: jdk.incubator.vector
startup_s=0.15
run=1 query_s=0.50
run=2 query_s=0.55
categories 10
total_sum 299985000000
cat_0 29985000000 49975.0
cat_10 29991000000 49985.0
cat_15 29994000000 49990.0
26/11/04 18:36:29 INFO ShutdownHookManager: Shutdown hook called
26/11/04 18:36:29 INFO ShutdownHookManager: Deleting directory /tmp/spark-8c50c697-7751-4227-8523-4495eaa6dfa7
Читать результаты стоит в таком порядке. Сначала сверьте число категорий, общую сумму и первые три строки в обоих выводах. Они совпали, 10 категорий и сумма 299985000000, поэтому время сравнивать можно. На запросе разница ощутима. Spark на втором запуске отработал за 3.52 с, DuckDB за 0.55 с, при первом запуске 7.24 с против 0.50 с. У DuckDB второй запуск не быстрее первого, а у Spark быстрее вдвое, и это как раз прогрев JVM. Показатель startup_s у двух движков несопоставим по составу. У Spark 5.11 с это импорт pyspark и создание сессии, а у DuckDB 0.15 с это импорт библиотеки и настройка соединения. Запуск JVM командой spark-submit в первое число не входит, так что реальные стартовые издержки Spark заметно выше, а точная цифра по этому стенду неизвестна.
Чего этот прогон не доказывает, надо сказать прямо. Он не проверяет цифры исходника про 100 ГБ, потому что набор в тысячи раз меньше и целиком лежит в кэше файловой системы контейнера. Он не сравнивает кластер с одиночной машиной, не показывает поведение при нехватке памяти у Spark и не учитывает отказоустойчивость. Он показывает только механизм, то есть фиксированные накладные расходы Spark на одном узле. Насколько они зависят от настроек shuffle, мы проверим в заданиях.
Задания
Все три задания работают на тех же данных из /tmp/bench, поэтому сначала должен отработать gen_data.py. Решения прогоняются тем же способом, что и основной пример.
Задание 1. Число партиций shuffle и AQE
Измерьте время того же запроса в Spark local[4] при spark.sql.shuffle.partitions равном 200 и 8, с выключенным и включённым AQE. Для каждой комбинации возьмите лучшее из трёх запусков и покажите узлы Exchange в плане. Объясните, чем план с AQE отличается от плана без него.
Решение
Запрос собирается заново перед каждым запуском. Иначе адаптивный план, уже выполненный один раз, мог бы повторно использовать результаты прошлых стадий и исказить замер. План берётся у последнего выполненного запроса.
# task1_shuffle.py · Spark 4.0.4 · Python 3
import time
from pyspark.sql import SparkSession
import pyspark.sql.functions as F

spark = SparkSession.builder.appName("task1_shuffle").master("local[4]").getOrCreate()
spark.sparkContext.setLogLevel("WARN")
transactions = spark.read.parquet("/tmp/bench/transactions")
merchants = spark.read.parquet("/tmp/bench/merchants")


def build():
    return (
        transactions.filter(F.col("region") == "EMEA")
        .join(F.broadcast(merchants), "merchant_id")
        .groupBy("merchant_category")
        .agg(F.sum("amount").alias("total_amount"), F.avg("amount").alias("avg_amount"))
    )


def run(partitions, aqe):
    spark.conf.set("spark.sql.shuffle.partitions", str(partitions))
    spark.conf.set("spark.sql.adaptive.enabled", str(aqe).lower())
    best = None
    for _ in range(3):
        df = build()
        t = time.perf_counter()
        df.collect()
        d = time.perf_counter() - t
        best = d if best is None else min(best, d)
    plan = df._jdf.queryExecution().executedPlan().toString()
    print(f"shuffle.partitions={partitions} aqe={aqe} best_of_3_s={best:.2f}")
    for line in plan.splitlines():
        if "Exchange" in line or "AdaptiveSparkPlan" in line:
            print("   ", line.strip())


for partitions in (200, 8):
    for aqe in (False, True):
        run(partitions, aqe)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:36:33 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:36:33 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:36:33 INFO SparkContext: Java version 17.0.19
26/11/04 18:36:34 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
shuffle.partitions=200 aqe=False best_of_3_s=3.14
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=254]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=248]
shuffle.partitions=200 aqe=True best_of_3_s=1.75
    AdaptiveSparkPlan isFinalPlan=true
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=700]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=644]
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=618]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=613]
shuffle.partitions=8 aqe=False best_of_3_s=1.72
    +- Exchange hashpartitioning(merchant_category#5, 8), ENSURE_REQUIREMENTS, [plan_id=980]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=974]
shuffle.partitions=8 aqe=True best_of_3_s=1.51
    AdaptiveSparkPlan isFinalPlan=true
    +- Exchange hashpartitioning(merchant_category#5, 8), ENSURE_REQUIREMENTS, [plan_id=1426]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=1370]
    +- Exchange hashpartitioning(merchant_category#5, 8), ENSURE_REQUIREMENTS, [plan_id=1344]
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=1339]
Результат читается так. При 200 партициях AQE ускорил запрос с 3.14 с до 1.75 с. При 8 партициях выигрыш скромнее, 1.72 с без AQE и 1.51 с с ним. Без AQE уменьшение числа партиций с 200 до 8 почти вдвое сократило время, а с включённым AQE оба варианта близки, 1.75 с и 1.51 с. По документации AQE объединяет мелкие партиции после shuffle, и это согласуется с тем, что на 200 партициях он вернул почти всё потерянное время. Но в напечатанном плане Exchange у AQE по-прежнему показан с числом 200. Это не противоречие, потому что объединение выполняется в рантайме, а наш фильтр строк выводит только узлы Exchange и AdaptiveSparkPlan и не показывает узел чтения объединённых партиций. Сам механизм прогон напрямую не доказывает, он показывает лишь разницу во времени.
Задание 2. Sort-merge join вместо broadcast
Уберите подсказку broadcast и отключите автоматическую рассылку, выставив spark.sql.autoBroadcastJoinThreshold в -1. Сравните планы и время с вариантом, где порог оставлен по умолчанию, и покажите, где в плане появляется Exchange.
Решение
Подсказку в коде мы убираем, потому что она перекрыла бы порог. Адаптивный порог тоже выставляем в -1, иначе AQE мог бы превратить соединение обратно в broadcast уже во время выполнения.
# task2_join.py · Spark 4.0.4 · Python 3
import time
from pyspark.sql import SparkSession
import pyspark.sql.functions as F

spark = SparkSession.builder.appName("task2_join").master("local[4]").getOrCreate()
spark.sparkContext.setLogLevel("WARN")
transactions = spark.read.parquet("/tmp/bench/transactions")
merchants = spark.read.parquet("/tmp/bench/merchants")


def build():
    return (
        transactions.filter(F.col("region") == "EMEA")
        .join(merchants, "merchant_id")
        .groupBy("merchant_category")
        .agg(F.sum("amount").alias("total_amount"), F.avg("amount").alias("avg_amount"))
    )


def run(threshold):
    spark.conf.set("spark.sql.autoBroadcastJoinThreshold", str(threshold))
    spark.conf.set("spark.sql.adaptive.autoBroadcastJoinThreshold", str(threshold))
    best = None
    for _ in range(3):
        df = build()
        t = time.perf_counter()
        df.collect()
        d = time.perf_counter() - t
        best = d if best is None else min(best, d)
    plan = df._jdf.queryExecution().executedPlan().toString()
    print(f"autoBroadcastJoinThreshold={threshold} best_of_3_s={best:.2f}")
    for line in plan.splitlines():
        if "Join" in line or "Exchange" in line:
            print("   ", line.strip())


run(10485760)
run(-1)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:37:20 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:37:20 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:37:20 INFO SparkContext: Java version 17.0.19
26/11/04 18:37:21 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
autoBroadcastJoinThreshold=10485760 best_of_3_s=2.06
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=418]
    +- *(2) BroadcastHashJoin [merchant_id#2], [merchant_id#4], Inner, BuildRight, false
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=362]
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=336]
    +- BroadcastHashJoin [merchant_id#2], [merchant_id#4], Inner, BuildRight, false
    +- BroadcastExchange HashedRelationBroadcastMode(List(cast(input[0, int, false] as bigint)),false), [plan_id=331]
autoBroadcastJoinThreshold=-1 best_of_3_s=3.92
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=1079]
    +- *(5) SortMergeJoin [merchant_id#2], [merchant_id#4], Inner
    :        +- Exchange hashpartitioning(merchant_id#2, 200), ENSURE_REQUIREMENTS, [plan_id=967]
    +- Exchange hashpartitioning(merchant_id#4, 200), ENSURE_REQUIREMENTS, [plan_id=986]
    +- Exchange hashpartitioning(merchant_category#5, 200), ENSURE_REQUIREMENTS, [plan_id=932]
    +- SortMergeJoin [merchant_id#2], [merchant_id#4], Inner
    :  +- Exchange hashpartitioning(merchant_id#2, 200), ENSURE_REQUIREMENTS, [plan_id=924]
    +- Exchange hashpartitioning(merchant_id#4, 200), ENSURE_REQUIREMENTS, [plan_id=925]
Во втором варианте ищите в плане узел SortMergeJoin и два Exchange перед ним, по одному на каждую сторону соединения. Именно эти обмены и есть shuffle большой таблицы, от которого рассылка маленького справочника избавляет. По времени это 2.06 с с рассылкой против 3.92 с без неё.
Задание 3. Spill и нехватка памяти в DuckDB
Выставьте memory_limit ниже размера рабочего набора и задайте temp_directory. Покажите, что DuckDB сбрасывает состояние на диск, а при слишком малом лимите сообщает об ошибке. В качестве тяжёлого запроса возьмите агрегацию по txn_id, где у каждой строки своя группа.
Решение
Фоновый поток следит за размером временного каталога и запоминает пик. Запрос агрегирует 30 миллионов групп, поэтому состоянию агрегации нужно намного больше памяти, чем мы даём в двух последних прогонах.
# task3_spill.py · duckdb 1.5.6 · Python 3
import os
import shutil
import sys
import threading
import time
sys.path.insert(0, "/tmp/pylibs")
import duckdb

TMP = "/tmp/duck_spill"
QUERY = """
SELECT count(*) FROM (
    SELECT txn_id, SUM(amount) AS s
    FROM read_parquet('/tmp/bench/transactions/*.parquet')
    GROUP BY txn_id
)
"""


def dir_size(path):
    total = 0
    for root, _, files in os.walk(path):
        for name in files:
            try:
                total += os.path.getsize(os.path.join(root, name))
            except OSError:
                pass
    return total


def run(limit):
    shutil.rmtree(TMP, ignore_errors=True)
    os.makedirs(TMP)
    con = duckdb.connect()
    con.execute("SET threads = 4")
    con.execute(f"SET memory_limit = '{limit}'")
    con.execute(f"SET temp_directory = '{TMP}'")
    peak = [0]
    stop = threading.Event()

    def watch():
        while not stop.is_set():
            peak[0] = max(peak[0], dir_size(TMP))
            time.sleep(0.05)

    thread = threading.Thread(target=watch)
    thread.start()
    t = time.perf_counter()
    try:
        groups = con.execute(QUERY).fetchone()[0]
        status = f"ok groups={groups}"
    except Exception as exc:
        status = type(exc).__name__ + " " + str(exc).splitlines()[0]
    elapsed = time.perf_counter() - t
    stop.set()
    thread.join()
    print(f"memory_limit={limit} {status} time_s={elapsed:.2f} temp_peak_mb={peak[0] / 1e6:.0f}")
    con.close()


for limit in ("2GB", "300MB", "30MB"):
    run(limit)
WARNING: Using incubator modules: jdk.incubator.vector
memory_limit=2GB ok groups=30000000 time_s=1.42 temp_peak_mb=0
memory_limit=300MB ok groups=30000000 time_s=1.85 temp_peak_mb=342
memory_limit=30MB OutOfMemoryException Out of Memory Error: failed to allocate data of size 16.0 MiB (23.3 MiB/28.6 MiB used) time_s=1.17 temp_peak_mb=454
26/11/04 18:38:04 INFO ShutdownHookManager: Shutdown hook called
26/11/04 18:38:04 INFO ShutdownHookManager: Deleting directory /tmp/spark-49d84c76-6a7d-4573-b88f-07fa8a814109
Смотрите на два числа в каждой строке. При лимите 2 ГБ сброса нет, temp_peak_mb равен нулю, запрос занял 1.42 с. При 300 МБ временный каталог вырос до 342 МБ, значит, DuckDB сбросил состояние на диск, и время поднялось до 1.85 с. Это единственная пара прогонов, где рост времени можно приписать сбросу. На лимите 30 МБ запрос упал с OutOfMemoryException через 1.17 с, хотя до падения успел записать на диск 454 МБ. Время упавшего запроса нельзя сравнивать с успешными, потому что он не дошёл до результата. Это и есть граница, о которой предупреждает документация. Не каждый оператор можно сбросить на диск, и память всё равно нужна.
Что взять с собой
Главный вывод получается скромнее заголовков вроде «DuckDB в 9 раз быстрее». На одной машине Spark платит фиксированную цену за старт, планирование и shuffle, и эту цену можно заметно уменьшить настройками, а именно числом партиций, AQE и стратегией join. Единый процесс DuckDB эти издержки вообще не несёт, зато упирается в память и не восстанавливается после падения. Выбирайте движок по форме задачи. Если нужны стриминг, восстановление после сбоев или данные больше одного узла, берите Spark. Если задача помещается на узел и это обычный SQL над Parquet, сначала проверьте DuckDB на собственных данных. Разбор плана запроса, настроек shuffle и AQE на практике входит в курс Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX.