Итераторные applyInPandas и applyInArrow (Iterator applyInPandas and applyInArrow) задуманы как ответ на типичную беду PySpark, когда один горячий ключ целиком попадает в память одного Python-воркера и роняет задачу. На Spark 4.0.4 стенд эти итераторные групповые формы не принял, поэтому рабочим решением в этой версии служит mapInArrow. В статье разберём, как группа добирается до функции, чем форма с целой группой отличается от потокового чтения батчей и как переписать расчёт по ключу в потоковый.
Почему один горячий ключ роняет Python-воркер
Групповая функция в PySpark выглядит безобидно. Вы пишете groupBy(«device»).applyInPandas(f, schema) и получаете по одному вызову f на каждый ключ. Пока ключи примерно равны по размеру, всё работает. Когда один ключ несёт в десятки раз больше строк, чем остальные, все его строки оказываются в одной задаче, а значит в одном Python-процессе.
Память этого процесса не входит в кучу JVM. По документации Spark 4.0.4, если параметр spark.executor.pyspark.memory не задан, Spark не ограничивает память Python, и за то, чтобы не выйти за пределы overhead, отвечает приложение. Поэтому в кластере с жёстким лимитом памяти контейнера перекос в групповой Python-функции может закончиться превышением этого лимита. Замер на стенде в локальном режиме с лимитом 4 ГБ описан в практике ниже, падения там не было.
Привычные средства от перекоса здесь не помогают. Раздел про Adaptive Query Execution (AQE) в руководстве по настройке производительности описывает обработку перекоса для sort-merge join, то есть для соединений. Группировка по ключу с Python-функцией под это не подпадает, потому что ключ по смыслу операции неделим и Spark не вправе разрезать его сам.
Остаются два пути. Можно не требовать группу целиком и обрабатывать её кусками, либо разрезать горячий ключ вручную. Итераторные формы групповых функций реализуют первый путь, и именно ему посвящена эта статья.
Как группа доезжает до функции в grouped map
Чтобы понять, откуда берётся пик памяти, полезно проследить путь группы от шаффла до вызова функции. Схема ниже показывает две ветки, которые расходятся уже в самом воркере.
Шаффл, Arrow-батчи и сборка группы
Сначала Spark раскладывает строки по партициям шаффла по хешу ключа, поэтому все строки одного ключа сходятся в одной задаче. Затем JVM передаёт данные Python-воркеру пачками в формате Apache Arrow. Размер пачки в строках ограничивает параметр spark.sql.execution.arrow.maxRecordsPerBatch, а его значение по умолчанию составляет 10000. Дальше пути расходятся.
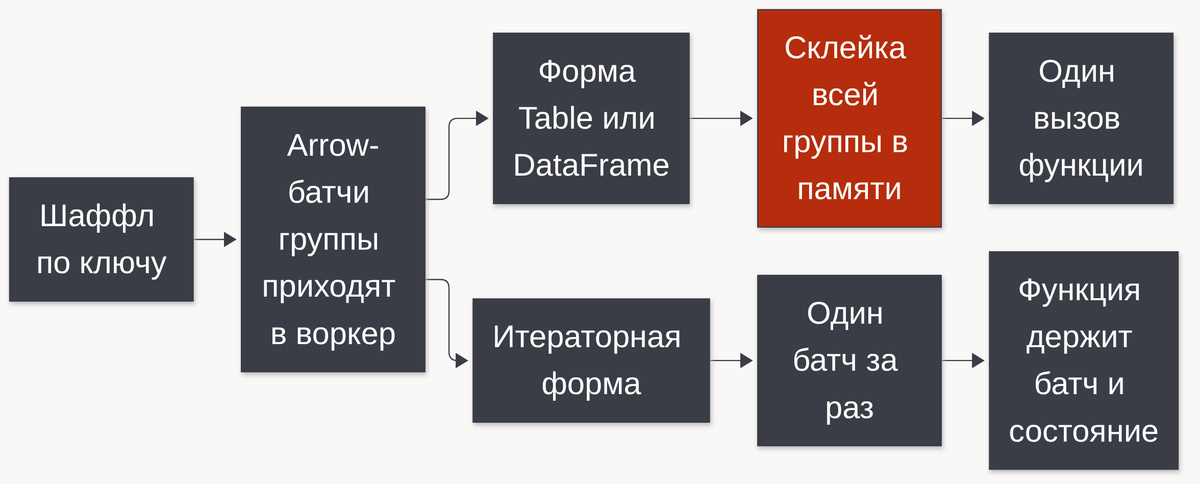
В форме с целой группой воркер накапливает все батчи ключа, склеивает их в pyarrow.Table или в pandas.DataFrame и только потом вызывает вашу функцию один раз. Для pandas добавляется ещё и конверсия из Arrow, и на стенде pandas показал больший пик памяти, чем Arrow. В итераторной форме функция получает батчи по одному и может отдавать результат по ходу чтения.
Что меняет итераторная форма
По замыслу итераторная форма выбирается по аннотациям. Функция принимает Iterator[pa.RecordBatch] и возвращает Iterator[pa.RecordBatch] для applyInArrow, а для applyInPandas вместо этого используется Iterator[pd.DataFrame]. На Spark 4.0.4 это не сработало. Spark вызвал функцию как обычную групповую, ждал pyarrow.Table или pandas.DataFrame, а получил generator, и задача завершилась ошибкой UDF_RETURN_TYPE. Поэтому потоковый расчёт на этой версии строится через mapInArrow, и замер памяти ниже относится именно к нему. Практические следствия потокового расчёта такие.
- Память воркера может остаться небольшой. В примере с
mapInArrowфункция держит в руках один батч и накопленное состояние. На этом стенде пик для hot ниже (126-134 МБ против 216 и 325 МБ при целой группе), но сравнение приблизительное. Это один запуск на одной конфигурации, а значениеru_maxrssотносится ко всему процессу воркера. Например, в первом прогоне у малого ключа d0 форма Arrow с целой группой показала 85 МБ, меньше потоковых 91 МБ. Замер не доказывает, что память не зависит от размера группы. - Вывод тоже может быть потоковым. Функция вправе отдать ноль, один или много батчей на группу, что удобно для фильтров.
- Целая группа недоступна. Вызвать
mean()илиsort_values()по всем строкам уже нельзя, расчёт нужно собирать по частям.
Таким образом, потоковый расчёт переносит ответственность за память с воркера на автора функции, и это честный размен.
Сравнение форм функции и альтернатив
Итераторная форма не единственный способ справиться с перекосом. В таблице собраны варианты, которые стоит держать в голове при выборе. Для итераторных форм в колонке версии указан результат прогона на Spark 4.0.4.
| Подход | Пик памяти воркера | Нужна вся группа сразу | Потоковый расчёт | Версия Spark |
|---|---|---|---|---|
| Встроенные агрегаты | Python не участвует, расчёт в JVM | нет | да, силами движка | любая |
applyInPandas, целый DataFrame |
325 МБ у hot на стенде, включая конверсию в pandas | да | нет | работает на 4.0.4 |
applyInArrow, целая Table |
216 МБ у hot на стенде | да | нет | работает на 4.0.4 |
applyInPandas, итератор DataFrame |
не измерен, форма не запустилась | нет | по замыслу да | на 4.0.4 не принята, ошибка UDF_RETURN_TYPE |
applyInArrow, итератор RecordBatch |
не измерен, форма не запустилась | нет | по замыслу да | на 4.0.4 не принята, ошибка UDF_RETURN_TYPE |
mapInArrow после repartition и sort |
126-134 МБ у hot на стенде, смену ключей отслеживает автор | нет | да | работает на 4.0.4 |
| Соль ключа | часть группы | нет, но только для разложимых расчётов | двухфазная агрегация | любая |
Разберём таблицу по сути. Если расчёт выражается встроенными агрегатами, берите их, потому что данные вообще не покидают JVM и ни о какой памяти воркера думать не нужно. Целая группа оправдана, когда логика требует всех строк разом, например сортировка по времени или обучение небольшой модели на группе, которая заведомо помещается в память.
Итераторные applyInPandas и applyInArrow по замыслу рассчитаны на расчёты по ключу, которые не укладываются во встроенные агрегаты, но раскладываются на накопление состояния. На Spark 4.0.4 они не запустились, поэтому эту роль здесь берёт mapInArrow. Для форм с целой группой разница измерена. На группе hot в 1,4 миллиона строк пик памяти воркера составил 216 МБ у Arrow и 325 МБ у pandas. Скорость работы мы не мерили.
Запасной путь на версиях без итераторных групповых форм это mapInArrow. Он работает с итератором батчей на уровне партиции, а не группы, поэтому сначала данные нужно перераспределить по ключу и отсортировать внутри партиции. Тогда строки одного ключа идут подряд, и функция сама замечает смену ключа. Это чуть больше кода, зато потоковое чтение доступно уже на 4.0.4.
Соль ключа остаётся классикой для сумм, счётчиков и максимумов. Горячему ключу добавляют случайный суффикс, считают частичные агрегаты и объединяют их вторым шагом. Для точной медианы или расчёта с порядком строк такой приём не подходит.
Как переписать расчёт по группе в потоковый
Любую потоковую функцию можно разложить на три части. Сначала задаётся пустое состояние, затем оно обновляется по каждому батчу, и в конце из состояния собирается ответ. Расчёт ложится в эту схему, если его можно собрать из небольших частичных результатов. Больше приёмов работы с группировками и пользовательскими функциями разбирает курс по Spark SQL.
- Подходят счётчики, суммы, минимумы и максимумы. Состояние это одно число на метрику, а среднее считается как сумма, делённая на счётчик.
- Подходят доли и частоты. Нужно хранить количество строк, удовлетворяющих условию, и общее количество.
- Подходят скользящие метрики с коротким хвостом. Между батчами переносится последние несколько значений, а не вся история.
- Не подходят точные квантили и полная сортировка. Им нужна вся группа, и здесь лучше оставить целую форму или перейти к приближённым алгоритмам.
Есть ещё одна тонкость. Если расчёт зависит от порядка строк, данные нужно явно отсортировать, как это делает решение третьего задания ниже.
Практика. Замер памяти воркера на перекошенных данных
Стенд состоит из одного контейнера со Spark 4.0.4. Код PySpark на хосте не запускается, потому что там нет Java, поэтому все скрипты идут через spark-submit внутри контейнера. Исходные файлы монтируются только на чтение, а Spark пишет свои временные данные в /tmp контейнера. Набор данных свой. Полтора миллиона строк, из которых миллион четыреста тысяч принадлежат одному устройству hot, а остальные поровну делят пять малых устройств.
Стенд
Образ Spark не содержит pandas и pyarrow, поэтому точка входа сервиса ставит их с фиксированными версиями и только после этого запускает sleep infinity. Проверка готовности убеждается, что обе библиотеки импортируются, и команда docker compose up —wait ждёт её. Порты не публикуются, лимит памяти контейнера 4 ГБ.
# compose.yaml · apache/spark 4.0.4 · pandas 2.2.3 · pyarrow 18.1.0
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    user: root
    mem_limit: 4g
    environment:
      PIP_BREAK_SYSTEM_PACKAGES: "1"
      PIP_NO_CACHE_DIR: "1"
    entrypoint: ["/bin/bash", "-c", "pip3 install pandas==2.2.3 pyarrow==18.1.0 && exec \"$$@\"", "--"]
    command: ["sleep", "infinity"]
    volumes:
      - ./:/work:ro
    healthcheck:
      test: ["CMD", "python3", "-c", "import pandas, pyarrow"]
      interval: 5s
      timeout: 20s
      retries: 60
      start_period: 10s
Скрипт запуска поднимает стенд и прогоняет три основных примера той же командой spark-submit. Гасит стенд внешний раннер, сам скрипт этого не делает.
#!/usr/bin/env bash
# run.sh · docker compose · Spark 4.0.4
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d --wait
for f in whole_group.py iterator_probe.py stream_map_in_arrow.py; do
  docker compose exec -T spark /opt/spark/bin/spark-submit \
    --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false "/work/$f"
done
Группа целиком
Первый скрипт строит данные и считает, сколько строк и чанков получает функция в форме целой группы. Пик памяти воркера берётся из модуля resource в момент возврата функции. На Linux ru_maxrss отдаёт килобайты, поэтому значение делится на 1024. Повторное использование воркеров выключено, чтобы пики разных задач не накладывались друг на друга. В выводе нужно сравнить пик памяти для ключа hot с пиками малых ключей, а форму pandas с формой Arrow.
# whole_group.py · PySpark 4.0.4 · pandas 2.2.3 · pyarrow 18.1.0
import resource

import pandas as pd
import pyarrow as pa
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .withColumn("note", F.repeat(F.lit("x"), 40)))

readings.groupBy("device").count().orderBy("device").show()


def peak_rss_mb():
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024


def arrow_whole(t: pa.Table) -> pa.Table:
    return pa.table({"device": [t.column("device")[0].as_py()],
                     "rows": [t.num_rows],
                     "chunks": [t.column("device").num_chunks],
                     "peak_rss_mb": [peak_rss_mb()]})


def pandas_whole(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"device": [pdf["device"].iloc[0]],
                         "rows": [len(pdf)],
                         "peak_rss_mb": [peak_rss_mb()]})


(readings.groupBy("device")
 .applyInArrow(arrow_whole, "device string, rows long, chunks long, peak_rss_mb long")
 .orderBy("device").show())

(readings.groupBy("device")
 .applyInPandas(pandas_whole, "device string, rows long, peak_rss_mb long")
 .orderBy("device").show())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:26:19 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:26:19 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:26:19 INFO SparkContext: Java version 17.0.19
26/11/18 07:26:19 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
+------+-------+
|device|  count|
+------+-------+
|    d0|  20000|
|    d1|  20000|
|    d2|  20000|
|    d3|  20000|
|    d4|  20000|
|   hot|1400000|
+------+-------+

+------+-------+------+-----------+
|device|   rows|chunks|peak_rss_mb|
+------+-------+------+-----------+
|    d0|  20000|     1|         85|
|    d1|  20000|     1|        126|
|    d2|  20000|     1|        126|
|    d3|  20000|     1|        126|
|    d4|  20000|     1|        126|
|   hot|1400000|     1|        216|
+------+-------+------+-----------+

+------+-------+-----------+
|device|   rows|peak_rss_mb|
+------+-------+-----------+
|    d0|  20000|        127|
|    d1|  20000|        128|
|    d2|  20000|        128|
|    d3|  20000|        128|
|    d4|  20000|        128|
|   hot|1400000|        325|
+------+-------+-----------+
Первая таблица показывает распределение ключей. Вторая относится к applyInArrow, и колонка chunks говорит, из скольких кусков склеена колонка группы. Третья относится к applyInPandas. Сравните peak_rss_mb у hot и у малых ключей, а затем у Arrow и у pandas.
Проверка итераторной формы
Теперь те же данные идут через функции с итераторными аннотациями. Скрипт печатает версию PySpark и пытается выполнить обе формы. Если версия не принимает итераторную форму, прогон не падает целиком, а печатает имя исключения и последнюю строку его сообщения. Так выбор запасного пути опирается на вывод стенда, а не на предположение.
# iterator_probe.py · PySpark 4.0.4 · pandas 2.2.3 · pyarrow 18.1.0
import resource
from typing import Iterator

import pandas as pd
import pyarrow as pa
import pyspark
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .withColumn("note", F.repeat(F.lit("x"), 40)))

print("pyspark", pyspark.__version__)


def peak_rss_mb():
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024


def arrow_batches(batches: Iterator[pa.RecordBatch]) -> Iterator[pa.RecordBatch]:
    device, rows, count = None, 0, 0
    for b in batches:
        device = device or b.column("device")[0].as_py()
        rows += b.num_rows
        count += 1
    yield pa.RecordBatch.from_pydict({"device": [device], "rows": [rows],
                                      "batches": [count], "peak_rss_mb": [peak_rss_mb()]})


def pandas_chunks(chunks: Iterator[pd.DataFrame]) -> Iterator[pd.DataFrame]:
    device, rows, count = None, 0, 0
    for pdf in chunks:
        device = device or pdf["device"].iloc[0]
        rows += len(pdf)
        count += 1
    yield pd.DataFrame({"device": [device], "rows": [rows],
                        "batches": [count], "peak_rss_mb": [peak_rss_mb()]})


def short_error(e):
    lines = [l.strip() for l in str(e).splitlines() if l.strip()]
    hits = [l for l in lines
            if ("Error" in l or "Exception" in l) and not l.startswith(("at ", "File ", "..."))]
    return (hits[-1] if hits else (lines[0] if lines else ""))[:200]


def try_run(label, build):
    try:
        build().orderBy("device").show()
    except Exception as e:
        print(label, "->", type(e).__name__, short_error(e))


schema = "device string, rows long, batches long, peak_rss_mb long"
try_run("applyInArrow iterator",
        lambda: readings.groupBy("device").applyInArrow(arrow_batches, schema))
try_run("applyInPandas iterator",
        lambda: readings.groupBy("device").applyInPandas(pandas_chunks, schema))
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:26:49 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:26:49 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:26:49 INFO SparkContext: Java version 17.0.19
26/11/18 07:26:49 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
pyspark 4.0.4
26/11/18 07:27:14 ERROR Executor: Exception in task 0.0 in stage 2.0 (TID 2)
org.apache.spark.api.python.PythonException: Traceback (most recent call last):
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 2044, in main
    process()
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 2036, in process
    serializer.dump_stream(out_iter, outfile)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 219, in dump_stream
    super(ArrowStreamGroupUDFSerializer, self).dump_stream(batch_iter, stream)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 176, in dump_stream
    return super(ArrowStreamUDFSerializer, self).dump_stream(wrap_and_init_stream(), stream)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 115, in dump_stream
    for batch in iterator:
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 161, in wrap_and_init_stream
    for batch, _ in iterator:
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 208, in <genexpr>
    batch_iter = (
  File "/opt/spark/python/lib/pyspark.zip/pyspark/sql/pandas/serializers.py", line 201, in <genexpr>
    batch_iter = (
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 1848, in mapper
    return f(keys, vals)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 512, in <lambda>
    return lambda k, v: (wrapped(k, v), arrow_return_type)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 507, in wrapped
    verify_arrow_result(result, _assign_cols_by_name, expected_cols_and_types)
  File "/opt/spark/python/lib/pyspark.zip/pyspark/worker.py", line 420, in verify_arrow_result
    raise PySparkTypeError(
pyspark.errors.exceptions.base.PySparkTypeError: [UDF_RETURN_TYPE] Return type of the user-defined function should be pyarrow.Table, but is generator.

	at org.apache.spark.api.python.BasePythonRunner$ReaderIterator.handlePythonException(PythonRunner.scala:581)
	at org.apache.spark.sql.execution.python.PythonArrowOutput$$anon$1.read(PythonArrowOutput.scala:117)
	at org.apache.spark.api.python.BasePythonRunner$ReaderIterator.hasNext(PythonRunner.scala:532)
	at org.apache.spark.InterruptibleIterator.hasNext(InterruptibleIterator.scala:37)
	at scala.collection.Iterator$$anon$10.hasNext(Iterator.scala:601)
	at scala.collection.Iterator$$anon$9.hasNext(Iterator.scala:583)
	at scala.collection.Iterator$$anon$9.hasNext(Iterator.scala:583)
	at scala.collection.Iterator.isEmpty(Iterator.scala:466)
	at scala.collection.Iterator.isEmpty$(Iterator.scala:466)
	at scala.collection.AbstractIterator.isEmpty(Iterator.scala:1306)
	at scala.collection.IterableOnceOps.nonEmpty(IterableOnce.scala:967)
	at scala.collection.IterableOnceOps.nonEmpty$(IterableOnce.scala:967)
	at scala.collection.AbstractIterator.nonEmpty(Iterator.scala:1306)
	at org.apache.spark.rdd.RDD.$anonfun$takeOrdered$2(RDD.scala:1567)
	at org.apache.spark.rdd.RDD.$anonfun$takeOrdered$2$adapted(RDD.scala:1566)
	at org.apache.spark.rdd.RDD.$anonfun$mapPartitionsWithIndex$2(RDD.scala:918)
	at org.apache.spark.rdd.RDD.$anonfun$mapPartitionsWithIndex$2$adapted(RDD.scala:918)
… (пропущено строк: 157)
	at scala.collection.Iterator.isEmpty$(Iterator.scala:466)
	at scala.collection.AbstractIterator.isEmpty(Iterator.scala:1306)
	at scala.collection.IterableOnceOps.nonEmpty(IterableOnce.scala:967)
	at scala.collection.IterableOnceOps.nonEmpty$(IterableOnce.scala:967)
	at scala.collection.AbstractIterator.nonEmpty(Iterator.scala:1306)
	at org.apache.spark.rdd.RDD.$anonfun$takeOrdered$2(RDD.scala:1567)
	at org.apache.spark.rdd.RDD.$anonfun$takeOrdered$2$adapted(RDD.scala:1566)
	at org.apache.spark.rdd.RDD.$anonfun$mapPartitionsWithIndex$2(RDD.scala:918)
	at org.apache.spark.rdd.RDD.$anonfun$mapPartitionsWithIndex$2$adapted(RDD.scala:918)
	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:374)
	at org.apache.spark.rdd.RDD.iterator(RDD.scala:338)
	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:93)
	at org.apache.spark.TaskContext.runTaskWithListeners(TaskContext.scala:171)
	at org.apache.spark.scheduler.Task.run(Task.scala:147)
	at org.apache.spark.executor.Executor$TaskRunner.$anonfun$run$5(Executor.scala:647)
	at org.apache.spark.util.SparkErrorUtils.tryWithSafeFinally(SparkErrorUtils.scala:80)
	at org.apache.spark.util.SparkErrorUtils.tryWithSafeFinally$(SparkErrorUtils.scala:77)
	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:99)
	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:650)
	at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1136)
	at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:635)
	at java.base/java.lang.Thread.run(Thread.java:840)

26/11/18 07:27:18 ERROR TaskSetManager: Task 0 in stage 5.0 failed 1 times; aborting job
applyInPandas iterator -> PythonException pyspark.errors.exceptions.base.PySparkTypeError: [UDF_RETURN_TYPE] Return type of the user-defined function should be pandas.DataFrame, but is generator.
На Spark 4.0.4 обе формы закончились ошибкой UDF_RETURN_TYPE. Для applyInArrow она видна в трассировке задачи, для applyInPandas скрипт напечатал её строкой с меткой. Spark вызвал функцию как обычную групповую, ждал pyarrow.Table или pandas.DataFrame и получил generator, то есть итераторные аннотации режим не переключили. На 4.0.4 с такими аннотациями форма не заработала, поэтому дальше используем mapInArrow.
Потоковый вариант через mapInArrow
Запасной путь собирается из трёх шагов. Сначала repartition(4, «device») сводит строки ключа в одну партицию, затем sortWithinPartitions(«device») ставит их подряд, и наконец mapInArrow читает партицию батчами. Один батч может содержать несколько ключей, поэтому вспомогательная функция by_key режет его по ключам, а основная функция копит состояние и отдаёт строку результата при смене ключа и в конце партиции.
По ходу дела скрипт демонстрирует и размер батча. Второй прогон повышает maxRecordsPerBatch и смотрит только на ключ hot, так что колонка largest показывает, как параметр меняет размер порции.
# stream_map_in_arrow.py · PySpark 4.0.4 · pyarrow 18.1.0
import resource
from typing import Iterator

import pyarrow as pa
import pyarrow.compute as pc
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .withColumn("note", F.repeat(F.lit("x"), 40)))


def peak_rss_mb():
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024


def by_key(batches):
    for b in batches:
        col = b.column("device")
        devs = pc.unique(col).to_pylist()
        if len(devs) == 1:
            yield devs[0], b
        else:
            for dev in devs:
                yield dev, b.filter(pc.equal(col, dev))


def result(dev, rows, count, largest, total):
    return pa.RecordBatch.from_pydict({"device": [dev], "rows": [rows], "batches": [count],
                                       "largest": [largest], "mean": [round(total / rows, 3)],
                                       "peak_rss_mb": [peak_rss_mb()]})


def stream_stats(batches: Iterator[pa.RecordBatch]) -> Iterator[pa.RecordBatch]:
    cur, rows, count, largest, total = None, 0, 0, 0, 0.0
    for dev, part in by_key(batches):
        if dev != cur:
            if cur is not None:
                yield result(cur, rows, count, largest, total)
            cur, rows, count, largest, total = dev, 0, 0, 0, 0.0
        rows += part.num_rows
        count += 1
        largest = max(largest, part.num_rows)
        total += pc.sum(part.column("reading")).as_py()
    if cur is not None:
        yield result(cur, rows, count, largest, total)


schema = "device string, rows long, batches long, largest long, mean double, peak_rss_mb long"


def build():
    return (readings.repartition(4, "device")
            .sortWithinPartitions("device")
            .mapInArrow(stream_stats, schema))


build().orderBy("device").show()

spark.conf.set("spark.sql.execution.arrow.maxRecordsPerBatch", "50000")
build().where("device = 'hot'").show()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:27:24 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:27:24 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:27:24 INFO SparkContext: Java version 17.0.19
26/11/18 07:27:24 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
+------+-------+-------+-------+------+-----------+
|device|   rows|batches|largest|  mean|peak_rss_mb|
+------+-------+-------+-------+------+-----------+
|    d0|  20000|      2|  10000|47.999|         91|
|    d1|  20000|      2|  10000|47.995|         91|
|    d2|  20000|      2|  10000|47.996|        126|
|    d3|  20000|      2|  10000|47.997|         91|
|    d4|  20000|      2|  10000|47.998|         91|
|   hot|1400000|    140|  10000|  48.0|        126|
+------+-------+-------+-------+------+-----------+

+------+-------+-------+-------+----+-----------+
|device|   rows|batches|largest|mean|peak_rss_mb|
+------+-------+-------+-------+----+-----------+
|   hot|1400000|     29|  50000|48.0|        134|
+------+-------+-------+-------+----+-----------+
На этом стенде пик памяти для hot здесь ниже (126 и 134 МБ против 216 и 325 МБ в первом прогоне с целой группой). Расчёт в обоих случаях покрывает одни и те же строки, но функция в этой форме видит только порцию и счётчики. Значение ru_maxrss относится ко всему процессу воркера, а не к отдельному ключу, поэтому у малых ключей, обработанных тем же процессом, пик отличается (91 МБ и 126 МБ у d2). Один замер на одной конфигурации не доказывает, что память не зависит от размера группы, он показывает только разницу на этом стенде.
Во втором выводе видно действие параметра. При значении по умолчанию 10000 ключ hot прошёл за 140 батчей с largest 10000, а после повышения maxRecordsPerBatch до 50000 за 29 батчей с largest 50000. Среднее осталось 48.0, пик памяти воркера в этом прогоне составил 134 МБ против 126 МБ при размере порции по умолчанию. Разница в 8 МБ лежит в пределах разброса одиночного замера, и делать из неё вывод нельзя. Ожидаемо, что при ещё более крупных батчах пик будет расти, потому что функция держит в памяти целую порцию. Поэтому размер батча стоит выбирать вместе с замером памяти, а не считать потоковую форму бесплатной по памяти.
Задания
Все решения написаны на mapInArrow, потому что итераторные групповые формы на 4.0.4 не запустились. Каждый файл прогоняется на том же стенде.
Задание 1. Потоковые среднее, максимум и доля
Перепишите расчёт среднего, максимума и доли значений не ниже порога 90 по каждому устройству так, чтобы память функции не зависела от размера группы.
▶ Решение (нажмите, чтобы открыть)
Состояние это четыре числа, счётчик, сумма, максимум и количество значений не ниже порога. Среднее и долю считаем при выдаче результата.
# task1_stream_stats.py · PySpark 4.0.4 · pyarrow 18.1.0
import resource
from typing import Iterator

import pyarrow as pa
import pyarrow.compute as pc
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

THRESHOLD = 90.0

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .select("device", "id", "reading"))


def peak_rss_mb():
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024


def by_key(batches):
    for b in batches:
        col = b.column("device")
        devs = pc.unique(col).to_pylist()
        if len(devs) == 1:
            yield devs[0], b
        else:
            for dev in devs:
                yield dev, b.filter(pc.equal(col, dev))


def row(dev, n, total, peak, high):
    return pa.RecordBatch.from_pydict({"device": [dev], "n": [n],
                                       "mean": [round(total / n, 3)], "max": [peak],
                                       "high_share": [round(high / n, 4)],
                                       "peak_rss_mb": [peak_rss_mb()]})


def stats(batches: Iterator[pa.RecordBatch]) -> Iterator[pa.RecordBatch]:
    cur, n, total, peak, high = None, 0, 0.0, 0.0, 0
    for dev, part in by_key(batches):
        if dev != cur:
            if cur is not None:
                yield row(cur, n, total, peak, high)
            cur, n, total, peak, high = dev, 0, 0.0, 0.0, 0
        r = part.column("reading")
        n += len(r)
        total += pc.sum(r).as_py()
        peak = max(peak, pc.max(r).as_py())
        high += pc.sum(pc.greater_equal(r, THRESHOLD)).as_py()
    if cur is not None:
        yield row(cur, n, total, peak, high)


schema = "device string, n long, mean double, max double, high_share double, peak_rss_mb long"
(readings.repartition(4, "device")
 .sortWithinPartitions("device")
 .mapInArrow(stats, schema)
 .orderBy("device").show())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:27:58 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:27:58 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:27:58 INFO SparkContext: Java version 17.0.19
26/11/18 07:27:58 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
+------+-------+------+----+----------+-----------+
|device|      n|  mean| max|high_share|peak_rss_mb|
+------+-------+------+----+----------+-----------+
|    d0|  20000|47.999|96.0|    0.0722|        125|
|    d1|  20000|47.995|96.0|    0.0721|        125|
|    d2|  20000|47.996|96.0|    0.0721|        125|
|    d3|  20000|47.997|96.0|    0.0721|        125|
|    d4|  20000|47.998|96.0|    0.0721|        125|
|   hot|1400000|  48.0|96.0|    0.0722|        126|
+------+-------+------+----+----------+-----------+
Задание 2. Фильтр строк выше порога
Напишите фильтр, который отдаёт только строки со значением не ниже порога, и объясните, почему число выходных батчей может оказаться нулевым.
▶ Решение (нажмите, чтобы открыть)
Функция отдаёт батч только тогда, когда в нём нашлись подходящие строки. Если порог выше любого значения, не отдаётся ни одного батча, а результат это корректный пустой DataFrame. Для mapInArrow это подтверждает вывод прогона, где при недостижимом пороге число строк равно 0 и задача не падает. Для групповых форм это на стенде не проверялось. Скрипт прогоняет два порога, один достижимый и один недостижимый.
# task2_filter.py · PySpark 4.0.4 · pyarrow 18.1.0
from typing import Iterator

import pyarrow as pa
import pyarrow.compute as pc
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .select("device", "id", "reading"))


def make_filter(threshold):
    def keep_high(batches: Iterator[pa.RecordBatch]) -> Iterator[pa.RecordBatch]:
        for b in batches:
            hits = b.filter(pc.greater_equal(b.column("reading"), threshold))
            if hits.num_rows > 0:
                yield hits
    return keep_high


schema = "device string, id long, reading double"
base = readings.repartition(4, "device")

high = base.mapInArrow(make_filter(96.0), schema)
high.groupBy("device").count().orderBy("device").show()

nothing = base.mapInArrow(make_filter(1000.0), schema)
print("rows above 1000", nothing.count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:28:23 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:28:23 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:28:23 INFO SparkContext: Java version 17.0.19
26/11/18 07:28:23 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
+------+-----+
|device|count|
+------+-----+
|    d0|  207|
|    d1|  206|
|    d2|  206|
|    d3|  206|
|    d4|  206|
|   hot|14432|
+------+-----+

rows above 1000 0
Задание 3. Скользящая метрика с небольшим состоянием
Целая группа нужна по смыслу, когда расчёт зависит от порядка строк или требует всех данных разом, например сортировка по времени или обучение небольшой модели. Но скользящее среднее по окну из пяти значений от всей истории не зависит. Найдите для каждого устройства максимум скользящего среднего, храня между батчами только короткий хвост.
▶ Решение (нажмите, чтобы открыть)
Порядок строк задаём явно через sortWithinPartitions по устройству и идентификатору. Между батчами переносятся последние четыре значения. Сумма окна считается через накопленную сумму, поэтому всё остаётся векторным.
# task3_rolling.py · PySpark 4.0.4 · pyarrow 18.1.0 · numpy
import resource
from typing import Iterator

import numpy as np
import pyarrow as pa
import pyarrow.compute as pc
from pyspark.sql import SparkSession, functions as F

spark = (SparkSession.builder.master("local[2]")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.python.worker.reuse", "false")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

WINDOW = 5

readings = (spark.range(0, 1_500_000)
            .withColumn("device", F.when(F.col("id") < 1_400_000, F.lit("hot"))
                        .otherwise(F.concat(F.lit("d"), (F.col("id") % 5).cast("string"))))
            .withColumn("reading", (F.col("id") % 97).cast("double"))
            .select("device", "id", "reading"))


def peak_rss_mb():
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss // 1024


def by_key(batches):
    for b in batches:
        col = b.column("device")
        devs = pc.unique(col).to_pylist()
        if len(devs) == 1:
            yield devs[0], b
        else:
            for dev in devs:
                yield dev, b.filter(pc.equal(col, dev))


def result(dev, best):
    value = round(best, 3) if best is not None else float("nan")
    return pa.RecordBatch.from_pydict({"device": [dev], "rolling_max": [value],
                                       "peak_rss_mb": [peak_rss_mb()]})


def rolling_peak(batches: Iterator[pa.RecordBatch]) -> Iterator[pa.RecordBatch]:
    cur, tail, best = None, np.empty(0), None
    for dev, part in by_key(batches):
        if dev != cur:
            if cur is not None:
                yield result(cur, best)
            cur, tail, best = dev, np.empty(0), None
        x = np.concatenate([tail, part.column("reading").to_numpy(zero_copy_only=False)])
        if len(x) >= WINDOW:
            c = np.cumsum(np.insert(x, 0, 0.0))
            top = float(((c[WINDOW:] - c[:-WINDOW]) / WINDOW).max())
            best = top if best is None else max(best, top)
        tail = x[-(WINDOW - 1):]
    if cur is not None:
        yield result(cur, best)


schema = "device string, rolling_max double, peak_rss_mb long"
(readings.repartition(4, "device")
 .sortWithinPartitions("device", "id")
 .mapInArrow(rolling_peak, schema)
 .orderBy("device").show())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/18 07:28:49 INFO SparkContext: Running Spark version 4.0.4
26/11/18 07:28:49 INFO SparkContext: OS info Linux, 7.0.0-1017-aws, amd64
26/11/18 07:28:49 INFO SparkContext: Java version 17.0.19
26/11/18 07:28:49 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
+------+-----------+-----------+
|device|rolling_max|peak_rss_mb|
+------+-----------+-----------+
|    d0|       86.0|        125|
|    d1|       86.0|        125|
|    d2|       86.0|        125|
|    d3|       86.0|        125|
|    d4|       86.0|        125|
|   hot|       94.0|        126|
+------+-----------+-----------+
Если хотите системно освоить группировки, оконные функции и пользовательские функции Spark, посмотрите наш курс по анализу данных со Spark Streaming, Spark SQL, MLlib и GraphX.