Watermark в Spark Structured Streaming обычно задают одной строкой и забывают, пока дашборд выглядит правдоподобно. Строка, пришедшая позже границы, не вызывает ни ошибки, ни предупреждения, она просто не попадает в окно. В статье разбираем, что именно обещает этот параметр, как движок двигает границу и закрывает окна, а затем воспроизводим потерю на одном контейнере Spark, чтобы считать её, а не угадывать.
О чём статья про watermark как контракт
Исходником служит пост Watermarks are a contract. Validating 150+ PySpark streams. Автор сравнивает watermark со временем отправления курьерского грузовика. Посылка, приехавшая на склад после отправления, всё ещё существует, но в сегодняшний рейс уже не попадёт, и клиенту никто не позвонит. По описанию автора, он столкнулся с этой проблемой на телеметрическом конвейере из более чем 150 потоков и в учебном проекте на симулированных данных.
Главная мысль поста в том, что watermark это не значение конфигурации, а обещание о трёх вещах сразу. Полнота отвечает на вопрос, насколько поздно может прийти событие, чтобы всё ещё попасть в окно. Состояние (state) определяет, как долго задача помнит старые ключи и окна. Задержка (latency) задаёт, сколько мы ждём перед выдачей результата. Узкая граница экономит память и ускоряет выдачу, но теряет больше опоздавших данных, а широкая делает наоборот.
Дальше автор предлагает не доверять watermark только потому, что задача не упала, и вводит три проверки. Первая это учёт опоздавших строк, когда каждый микропакет (micro-batch) публикует счётчики входных строк и строк ниже границы. Вторая это сверка окон, когда тот же расчёт повторяется как пакетный и сравнивается с потоковым результатом. Третья это проверка схемы с карантином для отбракованных записей. Вторая половина поста переносит идею на дневной watermark в JSON-файле для проекта на Delta Lake. Это пакетная история, и на нашем стенде она не воспроизводится.
Пост описывает подход на уровне идей и коротких фрагментов. Здесь мы добавим то, чего в нём нет. Это механика вычисления границы, сравнение значений watermark, воспроизводимый эксперимент и счётчик потерь, который можно проверить против пакетного пересчёта.
Что на самом деле обещает withWatermark
Вызов withWatermark принимает столбец со временем события (event time) и порог отставания. Движок отслеживает максимальное время события в данных и вычитает из него порог. Документация Spark 4.0.4 описывает правило так. Для окна, которое заканчивается в момент T, состояние хранится и позволяет опоздавшим данным обновлять окно, пока максимальное время события минус порог не станет больше T. Данные внутри порога агрегируются, а данные за порогом начинают отбрасываться.
Из этого правила следуют два вывода, которые легко упустить. Во-первых, граница относится к концу окна, а не к времени отдельной строки. Строка может лежать ниже текущего watermark по времени события и всё равно быть учтённой, если её окно ещё не закрылось. Поэтому счётчик опоздавших строк, который сравнивает время события с watermark напрямую, как в посте, нужно уточнять и сравнивать с watermark конец окна.
Во-вторых, отбрасывание тихое. В документации оно описано как штатное поведение, а не как сбой, поэтому ни исключения, ни записи в журнале ждать не стоит. Если вам нужна цифра потерь, её придётся посчитать самостоятельно. Ещё одна деталь из документации касается пакетных запросов. Для статического набора данных вызов withWatermark ничего не делает, потому что граница не должна влиять на пакетный расчёт. Именно это делает возможной вторую проверку из поста, ведь тот же запрос на статических данных даёт результат без потерь.
Как Spark вычисляет watermark и закрывает окна
Граница вычисляется в начале каждого триггера по данным предыдущих пакетов. В документации это показано на примере. Когда движок видит событие 12:14, он выставляет watermark 12:04 для следующего триггера при пороге 10 минут. Событие 12:09, пришедшее вне порядка, всё ещё впереди границы 12:04, и окна 12:00-12:10 и 12:05-12:15 обновляются корректно. Когда граница доходит до 12:11, состояние окна 12:00-12:10 очищается, и последующие события вроде 12:04 считаются слишком поздними и игнорируются.
Временная ось одного окна
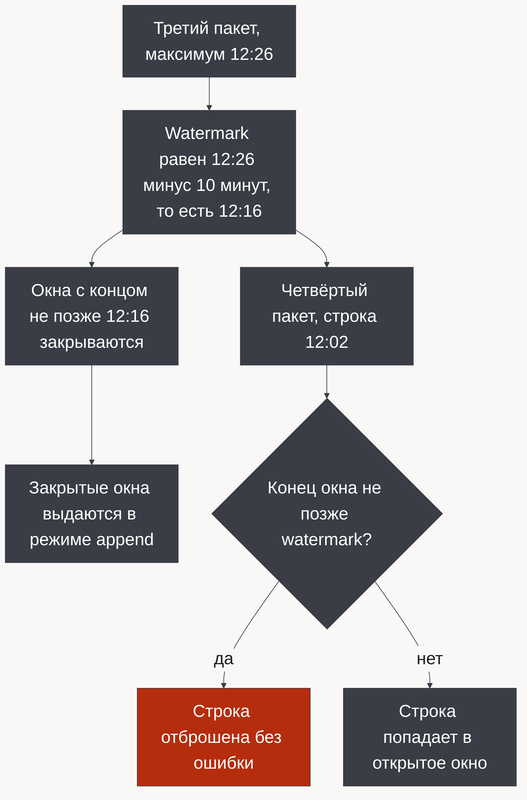
На схеме ниже показан тот же механизм на данных нашего стенда. Максимум времени события в третьем пакете сдвигает границу, окна до неё закрываются, а строка из следующего пакета проверяется по концу своего окна.
Режимы append и update
Поведение опоздавших строк зависит от режима вывода (output mode). В режиме update движок после каждого триггера пишет в приёмник (sink) обновлённые строки результата и продолжает обновлять окно, пока оно не станет старше watermark. В режиме append в приёмник попадают только окончательные значения. Частичные счётчики не публикуются, движок ждёт заданный порог, затем удаляет состояние окна и добавляет итог. По документации, итог окна 12:00-12:10 появляется только после того, как watermark сдвинется до 12:11.
Отсюда практический вывод. В append окно выдаётся, когда граница достигла его конца, то есть не раньше чем через порог после конца окна по времени события, а в update результат виден сразу, но потребитель получает несколько версий одного окна. Файловые приёмники, как сказано в документации, могут не поддерживать построчные обновления, которых требует update, и для них остаётся append.
Сводим варианты в таблицу. Момент закрытия окон и потерю опоздавших строк для порогов 2 и 10 минут показывают прогоны в практике ниже. Размер состояния прогоны не измеряли, выводы о нём опираются на документацию. Столбец без watermark тоже опирается на документацию и на стенде не запускался. Строка про риск тихой потери это оценка, а не замер.
| Критерий | Без watermark | Короткий (2 минуты) | Средний (10 минут) |
|---|---|---|---|
| Полнота при опоздании | Любое опоздание обновляет старое окно | Учитываются данные, отставшие не больше чем на 2 минуты от максимума | Учитываются данные, отставшие не больше чем на 10 минут от максимума |
| Размер состояния | Не ограничен, движок не знает, когда окно можно удалить | Минимальный, окно живёт недолго после закрытия границы | Больше, окна ждут дольше |
| Момент закрытия окна | Окно не закрывается | Когда максимум минус 2 минуты достиг конца окна | Когда максимум минус 10 минут достиг конца окна |
| Поведение в update | Окно обновляется бесконечно | Обновления прекращаются раньше, поздние строки отбрасываются раньше | Обновления идут дольше, отбрасывание позже |
| Риск тихой потери | Нет потери, но растёт состояние | Высокий, пока опоздания не измерены | Ниже, но не нулевой |
Выбирать приходится между памятью и полнотой. Вариант без watermark подходит для коротких экспериментов и ограниченных по объёму потоков, но для задачи, которая живёт днями, документация прямо требует ограничить состояние. Короткий watermark по документации выигрывает по задержке и памяти, но только если опоздания действительно редки, а размер состояния в нашем прогоне не замерялся. Средний значение выигрывает там, где важна полнота, и платит за это ожиданием в режиме append. Универсально правильного порога нет, есть только явно заданный и измеренный.
Три проверки контракта и их ограничения
Идея из поста сводится к тому, что обещание нужно проверять данными, а не отсутствием ошибок. Из трёх проверок две можно воспроизвести на малом стенде, а третья, проверка схемы, зависит от конкретных данных и в наш пример не входит. Базовые операции над потоковыми DataFrame, на которых построены обе проверки, мы разбираем на курсе Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX.
Учёт опоздавших строк требует решить, где его считать. Мы сравниваем три способа, и у каждого своя цена. Стоимость в таблице это качественная оценка, а точность счётчика и сверки подтверждает прогон ниже.
| Способ | Стоимость | Точность |
|---|---|---|
| Счётчик по правилу watermark в отдельном запросе | Низкая, считаются только счётчики по входным строкам | Зависит от того, насколько точно воспроизведено правило движка |
| Карантин, то есть отдельный приёмник для опоздавших строк | Средняя, строки пишутся на диск | Та же, что у счётчика, но строки можно разобрать и переиграть |
| Сверка с пакетным пересчётом | Высокая, нужен повторный проход по входным данным | Высокая, расхождение видно по каждому окну |
Счётчик дёшев, но он остаётся моделью поведения движка, и никто не гарантирует, что модель не разойдётся с реальностью. Сверка с батчем дороже, зато она ловит расхождение независимо от того, как считался счётчик. Поэтому на практике их ставят вместе. Счётчик работает постоянно и показывает тренд, а сверка запускается по расписанию на ограниченном диапазоне времени и подтверждает, что счётчик не врёт. Карантин добавляется там, где потерянные строки нужно не только пересчитать, но и разобрать.
Сверка тоже имеет ограничение, о котором говорит и автор поста. Окно легитимно отличается, если поздняя запись пришла после закрытия окна, поэтому сравнивать нужно только окна, которые уже закрыты к моменту наблюдения. Ниже мы так и делаем, а границей служит максимальный watermark из прогресса запроса.
Практика. Опоздавшие события, счётчик потерь и сверка с батчем
Стенд состоит из одного контейнера Spark, внешних сервисов нет. Источником служит каталог с JSON-файлами. Мы пишем файлы по одному и читаем их потоком с опцией maxFilesPerTrigger равной 1, поэтому один файл соответствует одному микропакету. События лежат в пяти файлах, всего 14 строк, окно фиксированной ширины (tumbling window) равно 5 минутам, порог watermark равен 10 минутам, режим append.
Данные подобраны так, чтобы каждое поведение было видно отдельно. После третьего файла максимум времени события равен 12:26, и граница становится 12:16. Четвёртый файл приносит три строки с опозданием. Строки 12:02 a и 12:11 b относятся к окнам, которые заканчиваются в 12:05 и 12:15, то есть не позже границы 12:16. К моменту прихода четвёртого файла эти окна уже выданы в append и закрыты, поэтому обе строки должны быть отброшены, а выданные счётчики останутся прежними. Строка 12:15 a лежит ниже границы по времени события, но её окно заканчивается в 12:20, поэтому по правилу из документации она ещё учитывается. Остальные строки приходят вовремя.
По тому же правилу watermark, применяемый к данным файлов с первого по пятый, должен быть равен 1970-01-01 (начальное значение), 11:57, 12:04, 12:16 и 12:21, а после пятого файла граница уходит к 12:40. В прогрессе движка нумерация гуще, чем число файлов. После каждого пакета с данными идёт пустой пакет с нулём входных строк, и новая граница впервые применяется именно в нём. Поэтому файлам с первого по пятый соответствуют пакеты 0, 2, 4, 6 и 8, а пустые пакеты 1, 3, 5, 7 и 9 показывают уже сдвинутую границу. Первая строка прогресса с пустым watermark это запись до появления данных. Сверяйте значения с блоком прогресса с учётом такой нумерации.
Стенд
Файл compose.yaml описывает единственный сервис. Данные пишутся только в каталог /tmp контейнера, потому что том /work смонтирован на чтение.
# compose.yaml · apache/spark 4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    command: ["sleep", "infinity"]
    mem_limit: 2g
    volumes:
      - ./:/work:ro
Скрипт run.sh поднимает стенд и запускает основной пример. Остановкой стенда занимается раннер.
#!/usr/bin/env bash
# run.sh · Docker Compose · Spark 4.0.4
set -euo pipefail
docker compose up -d --wait
docker compose exec -T spark /opt/spark/bin/spark-submit --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false /work/watermark_contract.py
Общий модуль эксперимента
Модуль wm_lab.py содержит всю логику, а скрипты экспериментов остаются короткими. Функция run запускает два потоковых запроса на одном каталоге. Первый агрегирует события с watermark и в режиме foreachBatch собирает то, что движок отдал в приёмник. Второй читает те же файлы без агрегации и считает входные строки и опоздавшие по правилу из документации, то есть сравнивает с границей конец окна. Границу этот запрос ведёт сам, как максимум времени события из прошлых пакетов минус порог.
После остановки запросов функция берёт максимальный watermark из прогресса агрегирующего запроса и считает его пределом сверки. Функция report печатает прогресс, учёт входа, всё, что получил приёмник, и расхождения с пакетным пересчётом через exceptAll в обе стороны.
# wm_lab.py · PySpark 4.0.4 · Spark 4.0.4
import json
import os
import shutil
import time
from datetime import datetime, timedelta

from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from pyspark.sql.types import StringType, StructField, StructType, TimestampType

DAY = "2026-01-01"
FMT = "yyyy-MM-dd HH:mm:ss"
SCHEMA = StructType([
    StructField("event_time", TimestampType()),
    StructField("service", StringType()),
])
FILES = [
    [("12:01", "a"), ("12:03", "a"), ("12:04", "b"), ("12:07", "a")],
    [("12:12", "a"), ("12:14", "b"), ("12:09", "a")],
    [("12:26", "a"), ("12:21", "b")],
    [("12:02", "a"), ("12:11", "b"), ("12:15", "a"), ("12:31", "b")],
    [("12:50", "a")],
]


def make_spark(name):
    spark = (SparkSession.builder.appName(name)
             .config("spark.sql.session.timeZone", "UTC")
             .config("spark.sql.shuffle.partitions", "2")
             .getOrCreate())
    spark.sparkContext.setLogLevel("WARN")
    return spark


def write_file(src, stage, n, rows):
    tmp = os.path.join(stage, "part_%d.json" % n)
    with open(tmp, "w") as f:
        for hhmm, svc in rows:
            f.write(json.dumps({"event_time": "%sT%s:00" % (DAY, hhmm), "service": svc}) + "\n")
    os.rename(tmp, os.path.join(src, "batch_%d.json" % n))


def win_end(t):
    start = t.replace(second=0, microsecond=0) - timedelta(minutes=t.minute % 5)
    return start + timedelta(minutes=5)


def wait_for(check, timeout=20):
    t0 = time.time()
    while time.time() - t0 < timeout:
        if check():
            return True
        time.sleep(0.2)
    return False


def run(spark, files, delay_min, mode, tag, on_late=None):
    root = "/tmp/wm_%s" % tag
    shutil.rmtree(root, ignore_errors=True)
    src, stage = root + "/in", root + "/stage"
    os.makedirs(src)
    os.makedirs(stage)

    raw = (spark.readStream.schema(SCHEMA)
           .option("maxFilesPerTrigger", 1).json(src))
    agg = (raw.withWatermark("event_time", "%d minutes" % delay_min)
           .groupBy(F.window("event_time", "5 minutes"), "service").count())

    emitted, audit_log = [], []
    state = {"max": None}

    def sink(df, batch_id):
        rows = df.select(F.date_format("window.start", FMT).alias("start"),
                         F.date_format("window.end", FMT).alias("end"),
                         "service", "count").collect()
        emitted.extend((batch_id,) + tuple(r) for r in rows)

    def audit(df, batch_id):
        rows = df.select(F.date_format("event_time", FMT).alias("t"), "service").collect()
        times = [datetime.strptime(r["t"], "%Y-%m-%d %H:%M:%S") for r in rows]
        if state["max"]:
            wm = state["max"] - timedelta(minutes=delay_min)
        else:
            wm = datetime(1970, 1, 1)
        late = [(r["t"], r["service"]) for r, t in zip(rows, times) if win_end(t) <= wm]
        if times:
            state["max"] = max(times + ([state["max"]] if state["max"] else []))
        if on_late and late:
            on_late(batch_id, late)
        audit_log.append((batch_id, len(rows), len(late), wm.strftime("%Y-%m-%d %H:%M")))

    q_agg = (agg.writeStream.outputMode(mode).foreachBatch(sink)
             .option("checkpointLocation", root + "/ck_agg").start())
    q_aud = (raw.writeStream.foreachBatch(audit)
             .option("checkpointLocation", root + "/ck_aud").start())

    sent = 0
    for n, rows in enumerate(files, 1):
        write_file(src, stage, n, rows)
        sent += len(rows)
        wait_for(lambda: len(audit_log) >= n)
        wait_for(lambda: sum(p["numInputRows"] for p in q_agg.recentProgress) >= sent)
        q_agg.processAllAvailable()
    time.sleep(3)
    q_agg.stop()
    q_aud.stop()

    progress = sorted((p["batchId"], p["numInputRows"], p.get("eventTime", {}).get("watermark"))
                      for p in q_agg.recentProgress)
    marks = [m for _, _, m in progress if m]
    cutoff = max(marks).replace("T", " ")[:19] if marks else "1970-01-01 00:00:00"
    return {"src": src, "emitted": emitted, "audit": audit_log,
            "cutoff": cutoff, "progress": progress}


def batch_df(spark, res):
    events = spark.read.schema(SCHEMA).json(res["src"])
    return (events.groupBy(F.window("event_time", "5 minutes"), "service").count()
            .select(F.date_format("window.start", FMT).alias("start"),
                    F.date_format("window.end", FMT).alias("end"),
                    "service", "count"))


def streamed_rows(res):
    last = {}
    for _, start, end, svc, cnt in res["emitted"]:
        last[(start, end, svc)] = cnt
    return [(s, e, v, c) for (s, e, v), c in sorted(last.items()) if e <= res["cutoff"]]


def report(spark, res, title):
    print("== %s ==" % title)
    print("прогресс агрегации (batchId, входных строк, watermark движка)")
    for p in res["progress"]:
        print("  ", p)
    print("учёт входа (batchId, строк, опоздавших, watermark по правилу)")
    for a in res["audit"]:
        print("  ", a)
    print("выдача в приёмник (batchId, начало, конец, service, count)")
    for e in res["emitted"]:
        print("  ", e)
    print("сверка закрытых окон до", res["cutoff"])
    streamed = spark.createDataFrame(streamed_rows(res), ["start", "end", "service", "count"])
    batched = batch_df(spark, res).where(F.col("end") <= res["cutoff"])
    print("в батче есть, в потоке нет или отличается")
    batched.exceptAll(streamed).orderBy("start", "service").show(truncate=False)
    print("в потоке есть, в батче нет или отличается")
    streamed.exceptAll(batched).orderBy("start", "service").show(truncate=False)
    late_total = sum(a[2] for a in res["audit"])
    in_batch = batched.agg(F.sum("count")).first()[0] or 0
    in_stream = sum(r[3] for r in streamed_rows(res))
    print("опоздавших по счётчику", late_total, "расхождение с батчем", in_batch - in_stream)
Основной прогон
Основной скрипт запускает эксперимент с порогом 10 минут в режиме append и печатает отчёт.
# watermark_contract.py · PySpark 4.0.4 · Spark 4.0.4
import sys
sys.path.insert(0, "/work")
import wm_lab

spark = wm_lab.make_spark("watermark_contract")
res = wm_lab.run(spark, wm_lab.FILES, 10, "append", "main")
wm_lab.report(spark, res, "watermark 10 минут, режим append")
spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/10 23:14:17 INFO SparkContext: Running Spark version 4.0.4
26/11/10 23:14:17 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/10 23:14:17 INFO SparkContext: Java version 17.0.19
26/11/10 23:14:17 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/10 23:14:23 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:14:23 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:14:37 WARN DAGScheduler: Failed to cancel job group 2ddffeae-5cdd-461a-abf2-3a05143232c5. Cannot find active jobs for it.
26/11/10 23:14:37 WARN DAGScheduler: Failed to cancel job group 2ddffeae-5cdd-461a-abf2-3a05143232c5. Cannot find active jobs for it.
26/11/10 23:14:37 WARN DAGScheduler: Failed to cancel job group 13e5156b-c856-46ed-a1c3-7720ad2bcfd0. Cannot find active jobs for it.
26/11/10 23:14:37 WARN DAGScheduler: Failed to cancel job group 13e5156b-c856-46ed-a1c3-7720ad2bcfd0. Cannot find active jobs for it.
== watermark 10 минут, режим append ==
прогресс агрегации (batchId, входных строк, watermark движка)
   (0, 0, None)
   (0, 4, '1970-01-01T00:00:00.000Z')
   (1, 0, '2026-01-01T11:57:00.000Z')
   (2, 3, '2026-01-01T11:57:00.000Z')
   (3, 0, '2026-01-01T12:04:00.000Z')
   (4, 2, '2026-01-01T12:04:00.000Z')
   (5, 0, '2026-01-01T12:16:00.000Z')
   (6, 4, '2026-01-01T12:16:00.000Z')
   (7, 0, '2026-01-01T12:21:00.000Z')
   (8, 1, '2026-01-01T12:21:00.000Z')
   (9, 0, '2026-01-01T12:40:00.000Z')
учёт входа (batchId, строк, опоздавших, watermark по правилу)
   (0, 4, 0, '1970-01-01 00:00')
   (1, 3, 0, '2026-01-01 11:57')
   (2, 2, 0, '2026-01-01 12:04')
   (3, 4, 2, '2026-01-01 12:16')
   (4, 1, 0, '2026-01-01 12:21')
выдача в приёмник (batchId, начало, конец, service, count)
   (5, '2026-01-01 12:05:00', '2026-01-01 12:10:00', 'a', 2)
   (5, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'b', 1)
   (5, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'a', 1)
   (5, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'b', 1)
   (5, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'a', 2)
   (7, '2026-01-01 12:15:00', '2026-01-01 12:20:00', 'a', 1)
   (9, '2026-01-01 12:30:00', '2026-01-01 12:35:00', 'b', 1)
   (9, '2026-01-01 12:20:00', '2026-01-01 12:25:00', 'b', 1)
   (9, '2026-01-01 12:25:00', '2026-01-01 12:30:00', 'a', 1)
сверка закрытых окон до 2026-01-01 12:40:00
в батче есть, в потоке нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |3    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |2    |
+-------------------+-------------------+-------+-----+

в потоке есть, в батче нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |2    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |1    |
+-------------------+-------------------+-------+-----+

опоздавших по счётчику 2 расхождение с батчем 2
В выводе стоит посмотреть на три места. Блок прогресса показывает watermark, который движок применил к каждому пакету, и его нужно сравнить со значениями, которые мы вычислили по правилу выше. Блок выдачи показывает, в каком пакете закрылись окна. По правилу append окна должны появиться только после того, как граница ушла за их конец, то есть пять записей по трём окнам с концом не позже 12:16 (12:05, 12:10 и 12:15) выдаются в пустом пакете сразу после третьего файла, ещё до прихода опоздавших строк. Наконец, блоки расхождений показывают, какие окна в потоке меньше, чем в батче. Для четвёртого файла (в учёте входа это batchId 3) счётчик опоздавших по нашему правилу должен дать две строки, и на этом наборе данных столько же должна показать итоговая строка расхождения с батчем.
Прогон доказывает механику на одном контейнере, пяти файлах и 14 строках, один раз. Он не доказывает поведение на больших объёмах, с несколькими партициями и с непрерывным потоком, где граница двигается по данным со всех партиций сразу. Для таких условий счётчик нужно проверять заново.
Задания
Все решения используют тот же модуль wm_lab.py и запускаются так же, как основной пример.
Задание 1. Уменьшите watermark с 10 минут до 2 минут. Покажите, какие ещё строки теряются и как меняется момент выдачи окон в режиме append.
▶ Решение (нажмите, чтобы открыть)
Достаточно изменить порог в вызове run. По правилу границы строка 12:15 a теперь тоже должна быть потеряна. Перед четвёртым файлом граница равна 12:24, а окно этой строки заканчивается в 12:20, то есть не позже границы. Счётчик должен показать три опоздавшие строки вместо двух, а первое окно 12:00-12:05 должно закрыться уже после первого файла, потому что максимум 12:07 даёт границу 12:05. При пороге 10 минут то же окно выдаётся только после третьего файла.
# task1_short_watermark.py · PySpark 4.0.4 · Spark 4.0.4
import sys
sys.path.insert(0, "/work")
import wm_lab

spark = wm_lab.make_spark("task1")
res = wm_lab.run(spark, wm_lab.FILES, 2, "append", "t1")
wm_lab.report(spark, res, "watermark 2 минуты, режим append")
spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/10 23:14:45 INFO SparkContext: Running Spark version 4.0.4
26/11/10 23:14:45 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/10 23:14:45 INFO SparkContext: Java version 17.0.19
26/11/10 23:14:45 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/10 23:14:51 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:14:51 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:15:05 WARN DAGScheduler: Failed to cancel job group 87f78e01-ebfc-43b0-9a98-bcddec30fedd. Cannot find active jobs for it.
26/11/10 23:15:05 WARN DAGScheduler: Failed to cancel job group 87f78e01-ebfc-43b0-9a98-bcddec30fedd. Cannot find active jobs for it.
26/11/10 23:15:05 WARN DAGScheduler: Failed to cancel job group e69c9a78-b773-455c-9fdb-a85458111487. Cannot find active jobs for it.
26/11/10 23:15:05 WARN DAGScheduler: Failed to cancel job group e69c9a78-b773-455c-9fdb-a85458111487. Cannot find active jobs for it.
== watermark 2 минуты, режим append ==
прогресс агрегации (batchId, входных строк, watermark движка)
   (0, 0, None)
   (0, 4, '1970-01-01T00:00:00.000Z')
   (1, 0, '2026-01-01T12:05:00.000Z')
   (2, 3, '2026-01-01T12:05:00.000Z')
   (3, 0, '2026-01-01T12:12:00.000Z')
   (4, 2, '2026-01-01T12:12:00.000Z')
   (5, 0, '2026-01-01T12:24:00.000Z')
   (6, 4, '2026-01-01T12:24:00.000Z')
   (7, 0, '2026-01-01T12:29:00.000Z')
   (8, 1, '2026-01-01T12:29:00.000Z')
   (9, 0, '2026-01-01T12:48:00.000Z')
учёт входа (batchId, строк, опоздавших, watermark по правилу)
   (0, 4, 0, '1970-01-01 00:00')
   (1, 3, 0, '2026-01-01 12:05')
   (2, 2, 0, '2026-01-01 12:12')
   (3, 4, 3, '2026-01-01 12:24')
   (4, 1, 0, '2026-01-01 12:29')
выдача в приёмник (batchId, начало, конец, service, count)
   (1, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'b', 1)
   (1, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'a', 2)
   (3, '2026-01-01 12:05:00', '2026-01-01 12:10:00', 'a', 2)
   (5, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'a', 1)
   (5, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'b', 1)
   (7, '2026-01-01 12:20:00', '2026-01-01 12:25:00', 'b', 1)
   (9, '2026-01-01 12:30:00', '2026-01-01 12:35:00', 'b', 1)
   (9, '2026-01-01 12:25:00', '2026-01-01 12:30:00', 'a', 1)
сверка закрытых окон до 2026-01-01 12:48:00
в батче есть, в потоке нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |3    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |2    |
|2026-01-01 12:15:00|2026-01-01 12:20:00|a      |1    |
+-------------------+-------------------+-------+-----+

в потоке есть, в батче нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |2    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |1    |
+-------------------+-------------------+-------+-----+

опоздавших по счётчику 3 расхождение с батчем 3
Задание 2. Переведите запрос в режим update и объясните по выводу, чем отличается поведение со строками внутри допустимой границы и за ней.
▶ Решение (нажмите, чтобы открыть)
Меняется только режим. В блоке выдачи окна теперь появляются в пакетах с данными (batchId 0, 2, 4, 6 и 8), а пустые пакеты между ними ничего не выдают. Строка 12:09 a из второго файла лежит внутри допустимой границы, поэтому окно 12:05-12:10 выдаётся дважды, сначала в пакете 0 со счётчиком 1, затем в пакете 2 со счётчиком 2. Строки 12:02 a и 12:11 b из четвёртого файла за границей, поэтому для их окон новых версий в выдаче нет. Итоговая сверка должна показать те же две отброшенные строки.
# task2_update_mode.py · PySpark 4.0.4 · Spark 4.0.4
import sys
sys.path.insert(0, "/work")
import wm_lab

spark = wm_lab.make_spark("task2")
res = wm_lab.run(spark, wm_lab.FILES, 10, "update", "t2")
wm_lab.report(spark, res, "watermark 10 минут, режим update")
spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/10 23:15:13 INFO SparkContext: Running Spark version 4.0.4
26/11/10 23:15:13 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/10 23:15:13 INFO SparkContext: Java version 17.0.19
26/11/10 23:15:13 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/10 23:15:20 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:15:21 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:15:34 WARN DAGScheduler: Failed to cancel job group 09cc56aa-e061-49dd-a9bf-b3905963e618. Cannot find active jobs for it.
26/11/10 23:15:34 WARN DAGScheduler: Failed to cancel job group 09cc56aa-e061-49dd-a9bf-b3905963e618. Cannot find active jobs for it.
26/11/10 23:15:34 WARN DAGScheduler: Failed to cancel job group 9f30a6ac-32de-4538-8bc7-a0069a41877b. Cannot find active jobs for it.
26/11/10 23:15:34 WARN DAGScheduler: Failed to cancel job group 9f30a6ac-32de-4538-8bc7-a0069a41877b. Cannot find active jobs for it.
== watermark 10 минут, режим update ==
прогресс агрегации (batchId, входных строк, watermark движка)
   (0, 0, None)
   (0, 4, '1970-01-01T00:00:00.000Z')
   (1, 0, '2026-01-01T11:57:00.000Z')
   (2, 3, '2026-01-01T11:57:00.000Z')
   (3, 0, '2026-01-01T12:04:00.000Z')
   (4, 2, '2026-01-01T12:04:00.000Z')
   (5, 0, '2026-01-01T12:16:00.000Z')
   (6, 4, '2026-01-01T12:16:00.000Z')
   (7, 0, '2026-01-01T12:21:00.000Z')
   (8, 1, '2026-01-01T12:21:00.000Z')
   (9, 0, '2026-01-01T12:40:00.000Z')
учёт входа (batchId, строк, опоздавших, watermark по правилу)
   (0, 4, 0, '1970-01-01 00:00')
   (1, 3, 0, '2026-01-01 11:57')
   (2, 2, 0, '2026-01-01 12:04')
   (3, 4, 2, '2026-01-01 12:16')
   (4, 1, 0, '2026-01-01 12:21')
выдача в приёмник (batchId, начало, конец, service, count)
   (0, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'b', 1)
   (0, '2026-01-01 12:05:00', '2026-01-01 12:10:00', 'a', 1)
   (0, '2026-01-01 12:00:00', '2026-01-01 12:05:00', 'a', 2)
   (2, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'a', 1)
   (2, '2026-01-01 12:10:00', '2026-01-01 12:15:00', 'b', 1)
   (2, '2026-01-01 12:05:00', '2026-01-01 12:10:00', 'a', 2)
   (4, '2026-01-01 12:20:00', '2026-01-01 12:25:00', 'b', 1)
   (4, '2026-01-01 12:25:00', '2026-01-01 12:30:00', 'a', 1)
   (6, '2026-01-01 12:30:00', '2026-01-01 12:35:00', 'b', 1)
   (6, '2026-01-01 12:15:00', '2026-01-01 12:20:00', 'a', 1)
   (8, '2026-01-01 12:50:00', '2026-01-01 12:55:00', 'a', 1)
сверка закрытых окон до 2026-01-01 12:40:00
в батче есть, в потоке нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |3    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |2    |
+-------------------+-------------------+-------+-----+

в потоке есть, в батче нет или отличается
+-------------------+-------------------+-------+-----+
|start              |end                |service|count|
+-------------------+-------------------+-------+-----+
|2026-01-01 12:00:00|2026-01-01 12:05:00|a      |2    |
|2026-01-01 12:10:00|2026-01-01 12:15:00|b      |1    |
+-------------------+-------------------+-------+-----+

опоздавших по счётчику 2 расхождение с батчем 2
Задание 3. Добавьте отдельный приёмник для опоздавших строк, то есть карантин в Parquet в /tmp, и сверьте сумму count в результате и в карантине с общим числом входных строк.
▶ Решение (нажмите, чтобы открыть)
Функция run принимает обратный вызов для опоздавших строк. В нём мы дописываем строки в Parquet. После остановки запросов складываем строки, выданные в приёмник, строки из карантина и строки в окнах, которые ещё не закрылись и потому не выданы в режиме append. Сумма должна совпасть с 14 входными строками.
# task3_quarantine.py · PySpark 4.0.4 · Spark 4.0.4
import shutil
import sys
sys.path.insert(0, "/work")
from pyspark.sql import functions as F
import wm_lab

spark = wm_lab.make_spark("task3")
QUARANTINE = "/tmp/wm_quarantine"
shutil.rmtree(QUARANTINE, ignore_errors=True)


def to_quarantine(batch_id, late):
    df = spark.createDataFrame([(batch_id, t, s) for t, s in late],
                               ["batch_id", "event_time", "service"])
    df.write.mode("append").parquet(QUARANTINE)


res = wm_lab.run(spark, wm_lab.FILES, 10, "append", "t3", on_late=to_quarantine)

quarantined = spark.read.parquet(QUARANTINE).count()
batched = wm_lab.batch_df(spark, res)
total_in = batched.agg(F.sum("count")).first()[0]
still_open = batched.where(F.col("end") > res["cutoff"]).agg(F.sum("count")).first()[0] or 0
emitted = sum(r[3] for r in wm_lab.streamed_rows(res))

print("входных строк", total_in)
print("выдано в приёмник", emitted)
print("в карантине", quarantined)
print("в незакрытых окнах", still_open)
print("сумма сходится", emitted + quarantined + still_open == total_in)
spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/10 23:15:42 INFO SparkContext: Running Spark version 4.0.4
26/11/10 23:15:42 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/10 23:15:42 INFO SparkContext: Java version 17.0.19
26/11/10 23:15:42 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/10 23:15:49 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:15:49 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/10 23:16:08 WARN DAGScheduler: Failed to cancel job group 47ac7f47-68a6-419c-a082-9f102f5ece6d. Cannot find active jobs for it.
26/11/10 23:16:08 WARN DAGScheduler: Failed to cancel job group 47ac7f47-68a6-419c-a082-9f102f5ece6d. Cannot find active jobs for it.
26/11/10 23:16:08 WARN DAGScheduler: Failed to cancel job group efee3d08-a45c-4166-8e00-0cdcfda04d67. Cannot find active jobs for it.
26/11/10 23:16:08 WARN DAGScheduler: Failed to cancel job group efee3d08-a45c-4166-8e00-0cdcfda04d67. Cannot find active jobs for it.
входных строк 14
выдано в приёмник 11
в карантине 2
в незакрытых окнах 1
сумма сходится True
Если тема потоковой обработки вам близка, на курсе Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX мы разбираем окна, режимы вывода и работу с состоянием на практических задачах, как и здесь, на воспроизводимом стенде.
Референсные ссылки
- Watermarks are a contract. Validating 150+ PySpark streams, исходный пост об использовании watermark как контракта.
- Structured Streaming Programming Guide, APIs on DataFrames and Datasets, раздел про окна по времени события и обработку опоздавших данных.
- Structured Streaming Programming Guide, Getting Started, модель программирования, режимы вывода и время события.