Spark JDBC parallel read, то есть параллельное чтение из JDBC в Spark, решает типичную задачу инженера данных. Нужно забрать большую таблицу из реляционной базы и не получить в Spark UI одну задачу, которая два часа работает на кластере из шестнадцати узлов, и не положить при этом боевую базу. Ниже разберём, как Spark режет диапазон на запросы, что ломается при перекосе ключа и неверных границах, чем отличаются явные предикаты и как ведут себя соединения при записи. Всё проверим на стенде из Spark и PostgreSQL, без облака.
Почему JDBC-чтение по умолчанию идёт одной задачей
Исходник это пост Karan Pulyala на платформе DEV Community, Spark JDBC Parallel Reads on Azure Databricks. Автор берёт Azure SQL Database и показывает, как читать и писать таблицу через JDBC (Java Database Connectivity) параллельно.
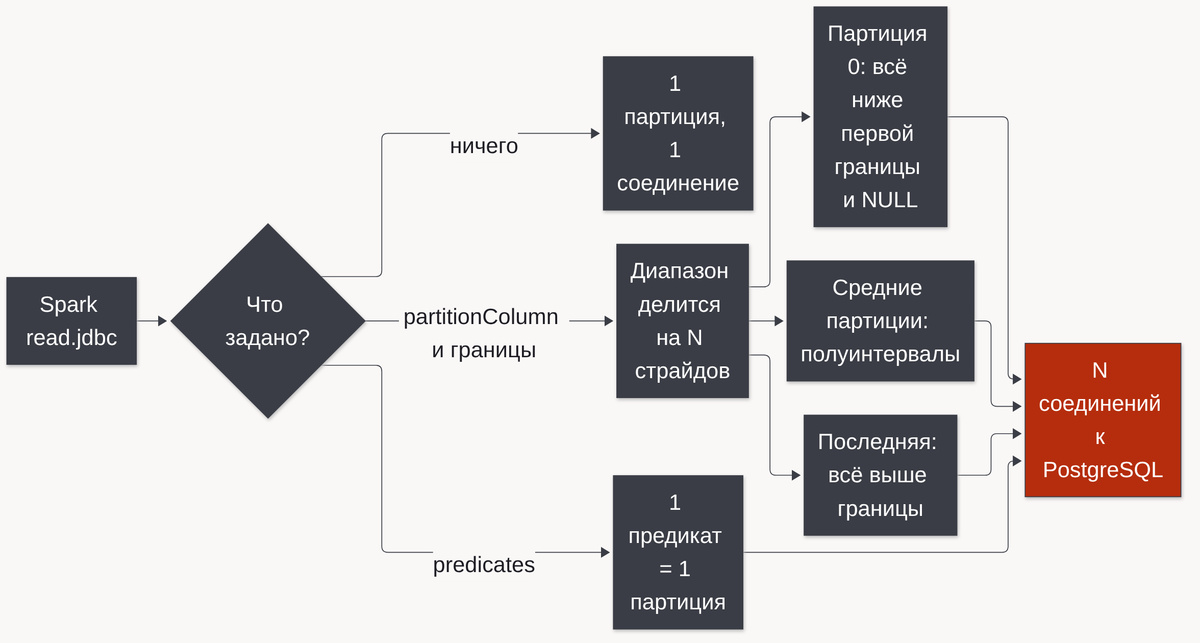
Главная мысль такая. Spark не знает, как поделить произвольную SQL-таблицу, поэтому без дополнительных опций открывает одно соединение и выполняет один SELECT по всей таблице. Получается одна партиция (partition), одна задача на одном ядре, и размер кластера ничего не меняет. Всё дальнейшее наследует эту единственную партицию, пока не случится shuffle.
Параллелизм включается четырьмя опциями вместе. Это partitionColumn, lowerBound, upperBound и numPartitions. По описанию автора Spark делит диапазон между границами на равные страйды (stride) и выполняет по одному запросу на страйд, каждый по своему соединению. Правила из поста такие. Границы ничего не фильтруют, а при неверных границах вы получаете не потерю строк, а одну огромную партицию. Столбец должен быть числовым, датой или временной меткой. Опцию query нельзя сочетать с partitionColumn. Столбец лучше брать индексированный. Для перекошенных ключей автор советует явные предикаты, а запись ограничивать через numPartitions, batchsize и truncate.
Детали Azure SQL на нашем стенде проверить нельзя, поэтому ниже мы смотрим поведение опций на PostgreSQL. Оно описано в документации Spark по JDBC-источникам данных.
Как Spark режет диапазон на запросы
Возьмём numPartitions равным N. Spark вычисляет страйд из границ и числа партиций и строит N условий. Первая партиция получает всё, что меньше первой границы, и NULL. Средние берут полуинтервалы вида «не меньше левой границы и меньше правой». Последняя берёт всё, что не меньше последней границы. На нашей таблице из 500000 строк с границами 1 и 500001 и четырьмя партициями вывод main.py показывает ровно это. Страйд равен 125000, а условия идут от «order_id < 125001 or order_id is null» до «order_id >= 375001».
Границы это не фильтр, а способ нарезки. Мы проверили это на узких границах от 1 до 1001. Вывод main.py и task2.py показывает партиции по 250, 250, 250 и 499250 строк, всего 500000, то есть ничего не потеряно, но последняя партиция раздулась почти до всей таблицы. Поэтому разумно сначала спросить у базы MIN и MAX, пусть это и лишний круг до источника.
Перекос ключа и явные предикаты
Страйды равны по значению, а не по числу строк. В таблице orders_gap идентификаторы идут от 1 до 100000 и от 1000001 до 1400000. С четырьмя страйдами на этой таблице распределение строк получилось 100000, 0, 50000 и 350000, то есть одна партиция пуста, а одна держит 70 процентов данных. Эти цифры относятся к одной таблице orders_gap и одной конфигурации, на другой раскладке ключей они будут иными. В Spark UI это выглядит как несколько долгих задач на фоне мгновенных.
Лекарство это явные предикаты (predicates). Каждый предикат становится ровно одной партицией. В задании 1 мы взяли остаток от деления order_id на 4 и получили 125000 строк в каждой партиции при совпавшем count с источником. Цена ручного управления в том, что автоматического улова для NULL и значений вне диапазона больше нет. Перекрывающиеся предикаты дублируют строки, а не покрывающие всё теряют их молча. В задании 2 месячные предикаты по shipped_date дали 125000 строк вместо 500000, то есть потеряно 375000, пока мы не добавили предикат IS NULL. Одна из защит от такой потери это сверка count() со значением COUNT(*) на стороне источника.
Что показал замер соединений
Исходник говорит, что numPartitions это и число одновременных соединений с базой. Мы проверили это при записи в задании 3, где монитор раз в 10 миллисекунд считает сессии PostgreSQL с именем приложения spark. Результат оказался неожиданным. Пик равен 5 и без numPartitions, и с numPartitions равным 4. Это единичный замер на одной машине в режиме local[8]. Пик 5 выше заявленных 4, и ограничение в этом замере его не снизило.
Почему так, прогон не доказывает. Вероятная причина в том, что DataFrame читается лениво, и во время записи рядом с четырьмя сессиями записи живут сессии чтения исходной таблицы с тем же именем spark. Это непроверенная гипотеза. Ещё один фактор в том, что монитор опрашивает базу с интервалом, и короткий пик мог проскочить. Поэтому границу числа соединений в numPartitions мы как проверенную не подаём. Если нагрузка на базу для вас критична, смотрите на число сессий в самой базе на вашем железе, а не только в настройках Spark. Всё это относится к одной машине с local[8], перенос на настоящий кластер остаётся предположением.
Практические приёмы из исходника, которые не зависят от облака.
- Нагрузка на базу. Число партиций определяет число запросов к источнику, поэтому смотрите на CPU и дисковый ввод-вывод самой базы, а не только на время Spark-задачи.
- Реплика вместо основной базы. Если есть читаемая реплика, читайте с неё.
- Pushdown. Фильтры после
load()уходят в SQL, а читаются только выбранные столбцы. В нашемmain.pyплан показывает PushedFilters с условием по status и ReadSchema из трёх столбцов.
Запись устроена так же. Каждая партиция DataFrame пишет по своему соединению. По документации Spark опция numPartitions при записи сводит число партиций к заданному (через coalesce), но на нашем стенде снижения пика соединений это не дало. Опция batchsize задаёт размер пачки INSERT, а truncate вместе с режимом overwrite заменяет DROP и CREATE на TRUNCATE. Прогон подтвердил главное свойство truncate. Индекс, созданный на целевой таблице, после overwrite без truncate пропал, а с truncate равным true остался. Запись, кроме того, не транзакционна между партициями. По исходнику, если одна из задач упала, партиции других задач уже могут быть зафиксированы, поэтому всё, что должно быть атомарным, пишите в промежуточную таблицу и подменяйте на стороне базы.
Эти механизмы подробно разбирает курс Основы Apache Spark для разработчиков и аналитиков, в том числе партиционирование и то, как число задач связано с числом ядер.
Сравнение способов забрать таблицу из PostgreSQL
JDBC в Spark не единственный путь. Для сравнения возьмём два режима Spark и расширение postgres для DuckDB, описанное в его документации. DuckDB на нашем стенде не запускался, поэтому столбец о нём построен только на документации.
| Критерий | Spark JDBC, partitionColumn |
Spark JDBC, predicates | DuckDB, расширение postgres |
|---|---|---|---|
| Как делится работа | Равные по значению страйды, на стенде по 125000 строк | Один предикат равен одной партиции, на стенде по 125000 строк | По страницам таблицы (ctid), по умолчанию 1000 страниц на задачу |
| Нагрузка на источник | Соединение на партицию. Единичный замер записи на local[8] дал пик 5 с ограничением и без, причина не выяснена | Соединение на предикат (исходник) | Документация упоминает настройки пула pg_pool_*, детали на отдельной странице |
| Перекос | На orders_gap 100000, 0, 50000 и 350000 строк |
Снимается выбором предикатов, на стенде по 125000 | Скан по ctid-страницам, про значения ключа не сказано |
| Pushdown фильтров | PushedFilters содержит условие по status | Проверяется так же через план | pg_enable_filter_pushdown, по умолчанию true |
| Запись | Нет транзакции между партициями (исходник) | Нет транзакции между партициями (исходник) | BEGIN и ROLLBACK, изоляция REPEATABLE READ по умолчанию |
Если таблица большая, ключ числовой и распределён плотно, достаточно partitionColumn, и он самый простой. Когда в ключе дыры или естественный разрез идёт по другому признаку (месяц, регион), выигрывают предикаты, но ответственность за полноту и непересечение ложится на вас, как показала потеря 375000 строк в задании 2. DuckDB, судя по документации, подходит, когда результат нужен не в кластере, а на одной машине. Нарезка у него идёт по страницам таблицы, а не по значениям ключа, и поэтому его поведение при дыре в ключе мы не оцениваем. У Spark атомарность записи приходится собирать вручную через staging-таблицу.
Практика. Spark и PostgreSQL на стенде
Стенд состоит из двух контейнеров. PostgreSQL 16.4 хранит две таблицы по 500 тысяч строк. Таблица orders имеет плотные идентификаторы от 1 до 500000. В таблице orders_gap идентификаторы с дырой, это строки 1-100000 и 1000001-1400000. Spark запускается из образа 4.0.4 в режиме local[8], потому что для демонстрации нам нужно именно число ядер и потоков, а не кластер.
Начнём с compose.yaml. Оба сервиса ограничены по памяти, порт PostgreSQL открыт только на локальном адресе, а healthcheck дожидается, пока seed.sql отработает целиком. Обычный pg_isready для этого не годится, потому что отвечает ещё во время инициализации.
# compose.yaml · postgres 16.4 · apache/spark 4.0.4
services:
  postgres:
    image: postgres:16.4
    mem_limit: 1g
    environment:
      POSTGRES_USER: spark
      POSTGRES_PASSWORD: spark
      POSTGRES_DB: shop
    ports:
      - "127.0.0.1:5432:5432"
    volumes:
      - ./seed.sql:/docker-entrypoint-initdb.d/seed.sql:ro
    healthcheck:
      test: ["CMD-SHELL", "psql -U spark -d shop -tAc 'SELECT count(*) FROM orders_gap' | grep -q 500000"]
      interval: 3s
      timeout: 5s
      retries: 40
      start_period: 5s
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    mem_limit: 3g
    working_dir: /tmp
    command: ["sleep", "infinity"]
    environment:
      SPARK_DIST_CLASSPATH: /jars/postgresql-42.7.4.jar
    depends_on:
      postgres:
        condition: service_healthy
    volumes:
      - ./:/work:ro
      - ./jars:/jars:ro
Теперь данные. В orders доля статуса SHIPPED равна четверти, и только у них заполнена дата отгрузки shipped_date, у остальных там NULL. Этот NULL понадобится в заданиях. Таблица orders_gap получается из orders сдвигом идентификаторов больше 100000 на 900000, а индексы копируются вместе с таблицей.
-- seed.sql · PostgreSQL 16.4
CREATE TABLE orders (
    order_id bigint PRIMARY KEY,
    customer_id int NOT NULL,
    status text NOT NULL,
    amount numeric(10,2) NOT NULL,
    order_date date NOT NULL,
    shipped_date date
);

INSERT INTO orders
SELECT g,
       (g % 5000) + 1,
       (ARRAY['NEW','PAID','SHIPPED','CANCELLED'])[1 + g % 4],
       round((random() * 500)::numeric, 2),
       DATE '2026-01-01' + (g % 180),
       CASE WHEN g % 4 = 2 THEN DATE '2026-01-01' + (g % 180) + 2 END
FROM generate_series(1, 500000) AS g;

CREATE TABLE orders_gap (LIKE orders INCLUDING ALL);

INSERT INTO orders_gap
SELECT CASE WHEN order_id <= 100000 THEN order_id ELSE order_id + 900000 END,
       customer_id, status, amount, order_date, shipped_date
FROM orders;
Spark-скрипты запускаются внутри контейнера, но удобно, чтобы их можно было вызвать и с хоста обычным python3. Для этого служит launcher.py. Если переменная SPARK_HOME не задана, значит мы на хосте, и скрипт пересылает сам себя в spark-submit внутри контейнера. Журнал Spark при этом уходит в файл, а в консоль попадают только результаты print.
# launcher.py · Python 3 · Spark 4.0.4
import os
import subprocess
import sys

JAR = "/jars/postgresql-42.7.4.jar"


def run_in_container(script):
    if os.environ.get("SPARK_HOME"):
        return
    name = os.path.basename(script)
    log_path = f"spark_{name}.log"
    cmd = [
        "docker", "compose", "exec", "-T", "spark",
        "/opt/spark/bin/spark-submit",
        "--master", "local[8]",
        "--jars", JAR,
        "--driver-class-path", JAR,
        "--conf", "spark.ui.enabled=false",
        "/work/" + name,
    ]
    with open(log_path, "w") as log:
        code = subprocess.call(cmd, stderr=log)
    if code != 0:
        with open(log_path) as log:
            sys.stderr.write(log.read()[-3000:])
    sys.exit(code)
Общие функции вынесены в common.py. Здесь четыре вещи. Это построение границ по MIN и MAX, профиль строк по партициям через spark_partition_id(), получение WHERE каждой партиции прямо из JVM (объекты JDBCPartition хранят whereClause) и монитор числа соединений. Монитор в отдельном потоке каждые 10 миллисекунд спрашивает у PostgreSQL число сессий с application_name равным spark и запоминает максимум. Имя приложения задано в URL, поэтому монитор и административные запросы свои же сессии не считают. Тексты WHERE мы берём из Spark, а не из лога PostgreSQL, потому что скрипт работает внутри контейнера и лога базы не видит.
# common.py · PySpark 4.0.4 · PostgreSQL JDBC 42.7.4 · PostgreSQL 16.4
import threading
import time

from pyspark.sql import SparkSession
from pyspark.sql import functions as F

BASE = "jdbc:postgresql://postgres:5432/shop"
URL = BASE + "?ApplicationName=spark"
PROPS = {"user": "spark", "password": "spark", "driver": "org.postgresql.Driver"}


def get_spark(name):
    spark = SparkSession.builder.appName(name).getOrCreate()
    spark.sparkContext.setLogLevel("WARN")
    return spark


def get_bounds(spark, table, col="order_id"):
    query = f"(SELECT MIN({col}) AS lo, MAX({col}) AS hi FROM {table}) AS b"
    row = spark.read.jdbc(URL, query, properties=PROPS).first()
    return row["lo"], row["hi"] + 1


def profile(df, n):
    rows = df.groupBy(F.spark_partition_id().alias("pid")).count().collect()
    counts = {r["pid"]: r["count"] for r in rows}
    return [counts.get(i, 0) for i in range(n)]


def where_clauses(df):
    parts = df._jdf.rdd().partitions()
    return [parts[i].whereClause() for i in range(len(parts))]


def _connect(spark, app):
    return spark._jvm.java.sql.DriverManager.getConnection(
        f"{BASE}?ApplicationName={app}", "spark", "spark")


def scalar(spark, sql):
    conn = _connect(spark, "admin")
    try:
        rs = conn.createStatement().executeQuery(sql)
        rs.next()
        return rs.getLong(1)
    finally:
        conn.close()


def execute(spark, sql):
    conn = _connect(spark, "admin")
    try:
        conn.createStatement().execute(sql)
    finally:
        conn.close()


class ConnectionMonitor:
    def __init__(self, spark):
        self._spark = spark
        self.peak = 0
        self._stop = threading.Event()
        self._thread = threading.Thread(target=self._loop, daemon=True)

    def _loop(self):
        conn = _connect(self._spark, "monitor")
        stmt = conn.createStatement()
        sql = "SELECT count(*) FROM pg_stat_activity WHERE application_name = 'spark'"
        while not self._stop.is_set():
            rs = stmt.executeQuery(sql)
            rs.next()
            self.peak = max(self.peak, rs.getInt(1))
            rs.close()
            time.sleep(0.01)
        conn.close()

    def __enter__(self):
        self._thread.start()
        return self

    def __exit__(self, *exc):
        self._stop.set()
        self._thread.join()
Основной пример main.py проходит по порядку всю первую половину темы. Читаем без параметров, затем с границами по MIN и MAX, затем с неверными границами, потом таблицу с дырой, и в конце проверяем pushdown.
# main.py · PySpark 4.0.4 · PostgreSQL 16.4
from launcher import run_in_container

run_in_container(__file__)

from common import URL, PROPS, get_spark, get_bounds, profile, where_clauses

spark = get_spark("main")
fast = {**PROPS, "fetchsize": "10000"}

plain = spark.read.jdbc(URL, "orders", properties=PROPS)
print("без параметров, партиций:", plain.rdd.getNumPartitions())

lo, hi = get_bounds(spark, "orders")
print("границы по MIN/MAX:", lo, hi)
ranged = spark.read.jdbc(URL, "orders", column="order_id", lowerBound=lo,
                         upperBound=hi, numPartitions=4, properties=fast)
print("с partitionColumn, партиций:", ranged.rdd.getNumPartitions())
print("строк по партициям:", profile(ranged, 4))
for i, clause in enumerate(where_clauses(ranged)):
    print("WHERE", i, clause)

wrong = spark.read.jdbc(URL, "orders", column="order_id", lowerBound=1,
                        upperBound=1001, numPartitions=4, properties=fast)
print("неверные границы 1..1001:", profile(wrong, 4), "всего", wrong.count())

glo, ghi = get_bounds(spark, "orders_gap")
gap = spark.read.jdbc(URL, "orders_gap", column="order_id", lowerBound=glo,
                      upperBound=ghi, numPartitions=4, properties=fast)
print("таблица с дырой, границы", glo, ghi, "->", profile(gap, 4))

shipped = ranged.filter("status = 'SHIPPED'").select("order_id", "customer_id", "amount")
shipped.explain()
print("SHIPPED строк:", shipped.count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:02:12 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:02:12 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:02:12 INFO SparkContext: Java version 17.0.19
26/11/03 02:02:12 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
без параметров, партиций: 1
границы по MIN/MAX: 1 500001
с partitionColumn, партиций: 4
строк по партициям: [125000, 125000, 125000, 125000]
WHERE 0 "order_id" < 125001 or "order_id" is null
WHERE 1 "order_id" >= 125001 AND "order_id" < 250001
WHERE 2 "order_id" >= 250001 AND "order_id" < 375001
WHERE 3 "order_id" >= 375001
неверные границы 1..1001: [250, 250, 250, 499250] всего 500000
таблица с дырой, границы 1 1400001 -> [100000, 0, 50000, 350000]
== Physical Plan ==
*(1) Scan JDBCRelation(orders) [numPartitions=4] [order_id#8L,customer_id#9,amount#11] PushedFilters: [*IsNotNull(status), *EqualTo(status,SHIPPED)], ReadSchema: struct<order_id:bigint,customer_id:int,amount:decimal(10,2)>


SHIPPED строк: 125000
Вывод подтверждает три вещи. Без параметров получается одна партиция, а с границами их четыре по 125000 строк. Первая партиция действительно захватывает NULL, а последняя не ограничена сверху. В плане PushedFilters содержит фильтр по status, а ReadSchema состоит только из трёх выбранных столбцов, то есть pushdown сработал. На нашей таблице orders_gap тот же способ даёт перекос 100000, 0, 50000 и 350000.
Остаётся скрипт запуска. Он скачивает JDBC-драйвер, если его нет, поднимает стенд и выполняет main.py. На хосте нужны только Docker, curl и python3 без сторонних пакетов, поэтому виртуальное окружение здесь не требуется. Стенд run.sh не гасит.
#!/usr/bin/env bash
# run.sh · Docker Compose · PostgreSQL 16.4 · Spark 4.0.4 · JDBC 42.7.4
set -euo pipefail

JAR=postgresql-42.7.4.jar
mkdir -p jars
if [ ! -f "jars/$JAR" ]; then
  curl -fsSL -o "jars/$JAR" "https://repo1.maven.org/maven2/org/postgresql/postgresql/42.7.4/$JAR"
fi

docker compose up -d --wait
python3 main.py
Задания
Каждое задание запускается на том же стенде. Файлы task1.py, task2.py и task3.py используют launcher.py и common.py из практики.
Задание 1. Выровнять перекос
Прочитайте orders_gap через partitionColumn с четырьмя партициями и покажите распределение строк по партициям. Затем замените нарезку на явные предикаты, которые дают примерно равные доли, и убедитесь, что count совпадает с источником.
▶ Решение (нажмите, чтобы открыть)
Удобный равномерный предикат это остаток от деления идентификатора на число партиций. Он не зависит от дыры в значениях. Мы проверяли только равномерность и полноту чтения, а план запроса в PostgreSQL для такого условия не смотрели, поэтому о стоимости чтения каждой партиции ничего не утверждаем. Для большой таблицы стоит отдельно сверить план. В выводе страйды дают перекос, а предикаты по 125000 строк и совпавший count.
# task1.py · PySpark 4.0.4 · PostgreSQL 16.4
from launcher import run_in_container

run_in_container(__file__)

from common import URL, PROPS, get_spark, get_bounds, profile

spark = get_spark("task1")

total = spark.read.jdbc(URL, "(SELECT count(*) AS c FROM orders_gap) AS t",
                        properties=PROPS).first()["c"]
lo, hi = get_bounds(spark, "orders_gap")

skew = spark.read.jdbc(URL, "orders_gap", column="order_id", lowerBound=lo,
                       upperBound=hi, numPartitions=4, properties=PROPS)
print("страйды:", profile(skew, 4))

predicates = [f"order_id % 4 = {i}" for i in range(4)]
even = spark.read.jdbc(URL, "orders_gap", predicates=predicates, properties=PROPS)
print("предикаты:", profile(even, 4))
print("count в Spark:", even.count(), "count в источнике:", total)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:02:29 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:02:29 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:02:29 INFO SparkContext: Java version 17.0.19
26/11/03 02:02:29 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
страйды: [100000, 0, 50000, 350000]
предикаты: [125000, 125000, 125000, 125000]
count в Spark: 500000 count в источнике: 500000
Задание 2. Неверные границы и строки, потерянные предикатами
Задайте границы внутри малой части диапазона orders и проверьте, теряются ли строки, а также выведите условие WHERE каждой партиции. Затем напишите предикаты по месяцам для столбца shipped_date, поймайте потерю строк сравнением count() и исправьте предикаты.
▶ Решение (нажмите, чтобы открыть)
С узкими границами строки не теряются, а последняя партиция раздувается до 499250 строк. Потеря возникает в другом месте. Сравнение с NULL в SQL никогда не даёт истину, поэтому месячные предикаты не захватывают строки с пустой датой отгрузки. В нашем прогоне потеряно 375000 строк из 500000. Исправление это отдельный предикат IS NULL, после которого потерь нет. Это иллюстрирует, что в варианте с предикатами автоматического улова для NULL нет.
# task2.py · PySpark 4.0.4 · PostgreSQL 16.4
from launcher import run_in_container

run_in_container(__file__)

from common import URL, PROPS, get_spark, profile, where_clauses

spark = get_spark("task2")

total = spark.read.jdbc(URL, "(SELECT count(*) AS c FROM orders) AS t",
                        properties=PROPS).first()["c"]

wrong = spark.read.jdbc(URL, "orders", column="order_id", lowerBound=1,
                        upperBound=1001, numPartitions=4, properties=PROPS)
for i, clause in enumerate(where_clauses(wrong)):
    print("WHERE", i, clause)
print("строк по партициям:", profile(wrong, 4), "всего", wrong.count(), "в источнике", total)

months = ["2026-01", "2026-02", "2026-03", "2026-04", "2026-05", "2026-06", "2026-07"]
leaky = [f"shipped_date >= DATE '{m}-01' AND shipped_date < DATE '{m}-01' + INTERVAL '1 month'"
         for m in months]
lost = spark.read.jdbc(URL, "orders", predicates=leaky, properties=PROPS)
print("предикаты без NULL:", lost.count(), "потеряно:", total - lost.count())

fixed = spark.read.jdbc(URL, "orders", predicates=leaky + ["shipped_date IS NULL"],
                        properties=PROPS)
print("с предикатом IS NULL:", fixed.count(), "потеряно:", total - fixed.count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:02:43 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:02:44 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:02:44 INFO SparkContext: Java version 17.0.19
26/11/03 02:02:44 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
WHERE 0 "order_id" < 251 or "order_id" is null
WHERE 1 "order_id" >= 251 AND "order_id" < 501
WHERE 2 "order_id" >= 501 AND "order_id" < 751
WHERE 3 "order_id" >= 751
строк по партициям: [250, 250, 250, 499250] всего 500000 в источнике 500000
предикаты без NULL: 125000 потеряно: 375000
с предикатом IS NULL: 500000 потеряно: 0
Задание 3. Запись с ограничением соединений
Запишите DataFrame из 200 партиций в PostgreSQL дважды, без numPartitions и с numPartitions равным 4, и сравните пиковое число соединений. Затем проверьте, удаляет ли overwrite без truncate индекс и сохраняет ли его режим с truncate равным true.
▶ Решение (нажмите, чтобы открыть)
Монитор из common.py считает сессии с именем приложения spark. Для проверки индекса после каждой записи мы спрашиваем pg_indexes. Вывод показывает два результата. Пик соединений равен 5 и без ограничения, и с numPartitions равным 4, поэтому ограничение в этом замере пик не снизило, а причину прогон не выясняет. Индекс при этом исчез после overwrite без truncate и сохранился с truncate равным true. Замер относится к одной машине с local[8], а монитор опрашивает базу раз в 10 миллисекунд, так что короткий пик мог проскочить незамеченным.
# task3.py · PySpark 4.0.4 · PostgreSQL 16.4
from launcher import run_in_container

run_in_container(__file__)

from common import URL, PROPS, get_spark, scalar, execute, ConnectionMonitor

spark = get_spark("task3")


def write(df, table, num=None, truncate=False):
    w = (df.write.format("jdbc")
         .option("url", URL).option("dbtable", table)
         .option("user", PROPS["user"]).option("password", PROPS["password"])
         .option("driver", PROPS["driver"])
         .option("batchsize", 10000)
         .mode("overwrite"))
    if num:
        w = w.option("numPartitions", num)
    if truncate:
        w = w.option("truncate", "true")
    w.save()


def has_index():
    return scalar(spark, "SELECT count(*) FROM pg_indexes WHERE indexname = 'idx_copy_status'")


for t in ("copy_a", "copy_b", "copy_t"):
    execute(spark, f"DROP TABLE IF EXISTS {t}")

src = spark.read.jdbc(URL, "orders", column="order_id", lowerBound=1,
                      upperBound=500001, numPartitions=8, properties=PROPS)
df = src.repartition(200)
print("партиций перед записью:", df.rdd.getNumPartitions())

with ConnectionMonitor(spark) as mon:
    write(df, "copy_a")
print("пик соединений без numPartitions:", mon.peak)

with ConnectionMonitor(spark) as mon:
    write(df, "copy_b", num=4)
print("пик соединений с numPartitions=4:", mon.peak)

write(df, "copy_t")
execute(spark, "CREATE INDEX idx_copy_status ON copy_t (status)")
print("индекс до перезаписи:", has_index())

write(df, "copy_t")
print("индекс после overwrite без truncate:", has_index())

execute(spark, "CREATE INDEX idx_copy_status ON copy_t (status)")
write(df, "copy_t", truncate=True)
print("индекс после overwrite с truncate=true:", has_index())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/03 02:03:00 INFO SparkContext: Running Spark version 4.0.4
26/11/03 02:03:00 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/03 02:03:00 INFO SparkContext: Java version 17.0.19
26/11/03 02:03:00 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
партиций перед записью: 200
пик соединений без numPartitions: 5
пик соединений с numPartitions=4: 5
индекс до перезаписи: 1
индекс после overwrite без truncate: 0
индекс после overwrite с truncate=true: 1
Если хотите разобраться, как Spark распределяет партиции по задачам и как число ядер связано с числом одновременных задач, это подробно разбирает курс Основы Apache Spark для разработчиков и аналитиков. На нём вы пройдёте ту же практику на более широком наборе источников и сможете переносить приёмы с PostgreSQL на свои промышленные базы.
Референсные ссылки
- Spark JDBC Parallel Reads on Azure Databricks, исходный пост Karan Pulyala.
- Документация расширения postgres для DuckDB, настройки пула соединений, pushdown и параллельного сканирования.
- Сайт драйвера PostgreSQL JDBC, драйвер версии 42.7.4 использован на стенде.