State Data Source в Spark 4 позволяет прочитать состояние стримингового запроса обычным батчевым чтением. Это решает типичную задачу отладки, когда счётчики Structured Streaming выглядят странно, а заглянуть в чекпоинт нечем. Состояние (state) лежит в каталоге чекпоинта, но раньше посмотреть на него как на таблицу было нельзя. Ниже разберём, откуда берётся состояние, как его читать и где подводные камни, а затем проверим всё на одном контейнере Spark 4.0.4. Основной пример в прогоне показал счётчики вдвое больше ожидаемых, и этот случай хорошо иллюстрирует, зачем вообще нужно читать состояние напрямую.
О чём исходник и что в нём сказано
Автор поста на Medium про State Data Source в Spark 4 начинает с наблюдения, что любой stateful-запрос держит рядом небольшую базу. Агрегации, дедупликация, соединения и окна хранят ключи и значения в папке state/ внутри чекпоинта. Долгое время о содержимом можно было только догадываться по выходу. В Spark 4.0 появились два батчевых ридера (batch reader). Источник state-metadata рассказывает, какие операторы с состоянием есть в чекпоинте и какой диапазон батчей доступен. Источник statestore возвращает ключи и значения как DataFrame. Автор отмечает, что функция помечена экспериментальной, поэтому опции и вывод могут измениться.
Главная идея поста в том, что состояние превращается из чёрного ящика в то, что можно запрашивать. Самый показательный сценарий автора связан с оконным запросом и дедупликацией, где в выходе не хватало окон 10:30. Оказалось, что ничего не потеряно. В режиме append окно записывается в приёмник только после того, как watermark перейдёт его конец, а до этого оно лежит в состоянии. Второй сценарий касается тестов, в которых проверяется само состояние, а не только приёмник.
Мы идём шире. Ниже собственные замеры на Spark 4.0.4 в контейнере, схема работы, сравнение с другими способами заглянуть в запрос и задания. Всё, что рассказано про наши числа, взято из нашего вывода.
Где живёт состояние стриминга
Состояние нужно операторам, которым для результата мало текущей строки. Это агрегации (groupBy со счётчиками, оконные агрегации), дедупликация через dropDuplicates и соединения потоков. Документация предупреждает, что Spark может внедрить такие операторы в план при интерпретации SQL, и тогда придётся думать о режиме вывода (output mode), watermark и размере хранилища состояния. Состояние нужно и для очистки. По документации, для окна, заканчивающегося в момент T, движок хранит состояние и принимает поздние данные, пока максимальное время события за вычетом порога задержки не превысит T.
Чекпоинт, хранилище и версии по батчам
Состояние хранится в хранилище состояния (state store) внутри каталога чекпоинта. Из лога прогона видно, что хранилище читается с диска по версиям, то есть записи имеют номер версии. Связь версии с номером микробатча (micro-batch) мы наблюдали на стенде, и простого правила из неё не вывести. В основном примере batchId был 2 и 3, а в логе встречались версии 2, 3 и 4. В задании 1 batchId был 0 и 1, а в логе встречаются версии 1 и 2. Какая версия соответствует какому из двух чтений, лог не различает, поэтому однозначного соответствия прогон не показал. В задании 2 с watermark в логе стоят версии 2, 4 и 6, то есть шаг равен двум на запуск. Это согласуется с тем, что при watermark движок добавляет к запуску ещё один батч, но сам прогон этого напрямую не подтверждает.
Отсюда практический вывод. Если нужен конкретный момент, номер батча передаётся опцией batchId, и сравнивать надо осознанно, сверяясь с метаданными и логом. В основном примере чтение без опции загрузило версию 4, а state-metadata показал maxBatchId равным 3. Похоже, что по умолчанию мы увидели состояние после последнего завершённого батча, но это проверено только на этом запросе.
Состояние бывает только у микробатчевого движка. Документация по режиму continuous processing перечисляет поддерживаемые операции, и агрегаций там нет, потому что поддерживаются только проекции и селекции. Так что всё сказанное здесь относится к обычному режиму микробатчей. Если вы только знакомитесь с этим механизмом, его системно разбирает курс по Spark Streaming, Spark SQL, MLlib и GraphX.
Как работает State Data Source
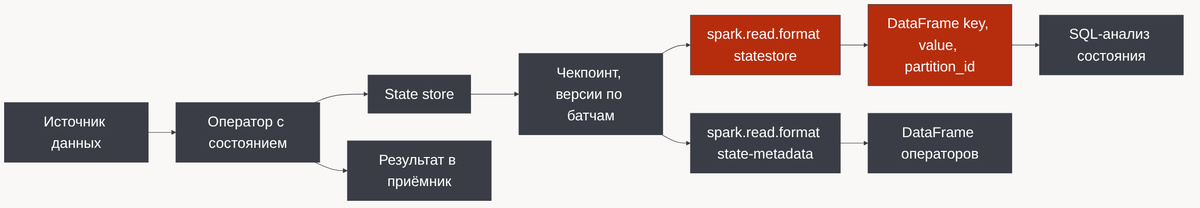
Идея в том, что состояние читается как обычный источник данных по пути чекпоинта. В нашем коде используются два формата. Формат state-metadata возвращает таблицу с описанием операторов, которые хранят состояние. Формат statestore возвращает строки самого состояния. Для второго формата мы применяем опции batchId (какую версию читать) и operatorId (состояние какого оператора, если их в запросе несколько). Чекпоинт при этом подаётся как путь в load.
Результат это DataFrame, у которого в нашем прогоне есть колонки key, value и partition_id. Ключ и значение приходят структурами, поля которых зависят от оператора. Для groupBy по слову ключ содержит слово, а значение содержит счётчик. Для оконной агрегации ключ включает структуру window с началом и концом окна. В нашем запросе с dropDuplicates значение пустое, в схеме оно показано как поле __dummy__ типа void, и вся информация лежит в ключе. Это наблюдение за одним запросом, для других операторов раскладка может быть иной. После чтения с состоянием можно работать любыми средствами DataFrame, включая SQL, джойны и группировки. Колонка partition_id говорит только о том, в какой партиции хранилища лежит ключ.
Ограничения и подводные камни
Первое ограничение в том, что это чтение. Состояние мы только читали и не проверяли, можно ли его править. Второе, схема зависит от оператора, а сама функция экспериментальная, поэтому скрипты анализа стоит перепроверять при обновлении Spark. Третье, батч нужно выбирать осознанно. Версия состояния не совпадает с batchId, и закономерность по нашим наблюдениям вывести нельзя. Четвёртое, в наших скриптах стрим уже остановлен (trigger availableNow), и мы читаем чекпоинт спокойно, без гонки с работающим запросом.
Пятая ловушка в том, что значения в состоянии надо сверять с входом. В основном примере вход состоял из двух порций, a, a, b, c и a, c, c, d. Ожидаемые счётчики равны 3 для a, 1 для b, 3 для c и 1 для d. В состоянии и в итоговой таблице получилось 6, 2, 6 и 2, то есть удвоены все четыре слова. В задании 1 на тех же входных данных получилось 3, 1, 3 и 1, как и ожидалось. Вероятная причина видна в самом скрипте, который не очищает каталоги /tmp/demo_in и /tmp/demo_ckpt. Номера батчей 2 и 3 вместо 0 и 1 говорят, что в чекпоинте уже лежали два батча. Если там было состояние 3, 1, 3, 1 от более раннего запуска и те же слова добавились снова, получается ровно 6, 2, 6, 2. Прямо прогон этого не доказывает, но объяснение согласуется со всеми числами. Вывод для практики простой. Перед экспериментом чистите каталоги входа и чекпоинта и проверяйте счётчики на небольшом известном входе.
Сравнение способов посмотреть состояние
State Data Source не единственный способ понять, что делает запрос. В таблице сопоставлены три подхода, и каждая ячейка опирается на то, что показал наш прогон или описывает исходник.
| Способ | Что видно | Выбор момента | SQL-анализ |
|---|---|---|---|
| State Data Source | Ключи и значения состояния строками DataFrame | Опция batchId, в наших запусках проверено чтение по batchId в задании 1 | Да, это обычный DataFrame |
| Прогресс запроса (lastProgress, recentProgress) | Номер батча, число входных строк, watermark | Запись по каждому батчу | Нет, это словарь с показателями |
| Результат в приёмнике (memory, parquet) | Только выходные строки, а не содержимое состояния | Только то, что уже записано в приёмник | Да, но по результату |
Если нужно знать, сколько строк пришло в батче и какой watermark, достаточно прогресса запроса. Результат в приёмнике подходит для проверки итоговых чисел, но в режиме append окно попадает туда только после watermark, поэтому по приёмнику легко решить, что данные потерялись. Когда надо понять, какой именно ключ хранится и с каким значением, выигрывает State Data Source, потому что остальные способы содержимое состояния не показывают.
Практика
Стенд состоит из одного сервиса Spark. Образ взят из кэша, том смонтирован только на чтение, чекпоинты и входные данные пишутся в /tmp контейнера. Сначала описание стенда.
# compose.yaml · apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    command: ["sleep", "infinity"]
    mem_limit: 3g
    volumes:
      - ./:/work:ro
#!/usr/bin/env bash
# run.sh · Docker Compose · Spark 4.0.4
set -euo pipefail
docker compose up -d --wait
docker compose exec -T spark /opt/spark/bin/spark-submit --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false /work/demo_state.py
Основной пример самодостаточен. Он пишет входные данные файлами JSON, запускает агрегацию count по слову с режимом complete и триггером availableNow, затем делает второй запуск на том же чекпоинте с новой порцией. Номер батча берётся из последнего прогресса запроса. После этого скрипт читает метаданные и состояние.
# demo_state.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import SparkSession

spark = (SparkSession.builder.appName("state-demo")
         .config("spark.sql.shuffle.partitions", "4")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

IN, CKPT = "/tmp/demo_in", "/tmp/demo_ckpt"


def add_batch(words):
    df = spark.createDataFrame([(w,) for w in words], "word string")
    df.write.mode("append").json(IN)


def run_once(name):
    src = spark.readStream.schema("word string").json(IN)
    q = (src.groupBy("word").count()
         .writeStream.outputMode("complete")
         .format("memory").queryName(name)
         .option("checkpointLocation", CKPT)
         .trigger(availableNow=True).start())
    q.awaitTermination()
    return q.lastProgress["batchId"]


add_batch(["a", "a", "b", "c"])
b1 = run_once("agg")
add_batch(["a", "c", "c", "d"])
b2 = run_once("agg")
print("batchId после первого и второго запуска:", b1, b2)

print("Результат самой агрегации")
spark.table("agg").orderBy("word").show()

print("state-metadata")
spark.read.format("state-metadata").load(CKPT).show(truncate=False)

print("statestore, последний батч")
state = spark.read.format("statestore").load(CKPT)
state.printSchema()
state.select("key.word", "value.*", "partition_id").orderBy("word").show()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/01 19:31:23 INFO SparkContext: Running Spark version 4.0.4
26/11/01 19:31:23 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/01 19:31:23 INFO SparkContext: Java version 17.0.19
26/11/01 19:31:24 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/01 19:31:33 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/01 19:31:35 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:35 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:35 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:35 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:36 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/01 19:31:37 WARN HDFSBackedStateStoreProvider: The state for version 3 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:37 WARN HDFSBackedStateStoreProvider: The state for version 3 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:37 WARN HDFSBackedStateStoreProvider: The state for version 3 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:37 WARN HDFSBackedStateStoreProvider: The state for version 3 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
batchId после первого и второго запуска: 2 3
Результат самой агрегации
+----+-----+
|word|count|
+----+-----+
|   a|    6|
|   b|    2|
|   c|    6|
|   d|    2|
+----+-----+

state-metadata
+----------+--------------+--------------+-------------+----------+----------+------------------+
|operatorId|operatorName  |stateStoreName|numPartitions|minBatchId|maxBatchId|operatorProperties|
+----------+--------------+--------------+-------------+----------+----------+------------------+
|0         |stateStoreSave|default       |4            |0         |3         |NULL              |
+----------+--------------+--------------+-------------+----------+----------+------------------+

statestore, последний батч
root
 |-- key: struct (nullable = true)
 |    |-- word: string (nullable = true)
 |-- value: struct (nullable = true)
 |    |-- count: long (nullable = false)
 |-- partition_id: integer (nullable = true)

26/11/01 19:31:38 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:38 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:38 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:38 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+----+-----+------------+
|word|count|partition_id|
+----+-----+------------+
|   a|    6|           2|
|   b|    2|           1|
|   c|    6|           2|
|   d|    2|           2|
+----+-----+------------+
В выводе стоит сопоставить два блока. Строки состояния по ключам совпадают с итоговой таблицей агрегации, потому что complete-режим выводит накопленные значения. Но абсолютные числа вдвое больше ожидаемых для такого входа. Для a ожидалось 3, а получено 6, для b вместо 1 стоит 2, для c вместо 3 стоит 6, для d вместо 1 стоит 2. Самое правдоподобное объяснение в том, что скрипт не очищает каталоги входа и чекпоинта, а батчи 0 и 1 в чекпоинте остались от более раннего запуска (подробнее в разделе про ограничения). Это гипотеза, которую прогон напрямую не проверял. Колонка partition_id показывает только раскладку ключей по партициям хранилища. Метаданные показывают один оператор stateStoreSave с четырьмя партициями и maxBatchId, равным 3. Предупреждения про версии 2, 3 и 4 в логе сообщают, что нужной версии нет в кэше загруженных состояний и она читается из снапшота и дельта-файлов. Какие именно из этих строк относятся к работе самого стрима, а какие к нашему чтению, прогон не разделяет.
Задания
Каждое решение это самостоятельный скрипт, который запускается теми же командами. Закрепить материал помогает подробный разбор стриминга в курсе Основы Apache Spark для разработчиков и аналитиков.
Задание 1. Выполните два запуска с availableNow на разных порциях и сравните значения счётчиков при batchId N и N-1.
Решение
# task1.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = (SparkSession.builder.appName("task1")
         .config("spark.sql.shuffle.partitions", "4")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

IN, CKPT = "/tmp/t1_in", "/tmp/t1_ckpt"


def add_batch(words):
    df = spark.createDataFrame([(w,) for w in words], "word string")
    df.write.mode("append").json(IN)


def run_once():
    src = spark.readStream.schema("word string").json(IN)
    q = (src.groupBy("word").count()
         .writeStream.outputMode("complete")
         .format("noop")
         .option("checkpointLocation", CKPT)
         .trigger(availableNow=True).start())
    q.awaitTermination()
    return q.lastProgress["batchId"]


def counts(batch, col_name):
    st = (spark.read.format("statestore")
          .option("batchId", batch).load(CKPT))
    return st.select(F.col("key.word").alias("word"),
                     F.col("value.count").alias(col_name))


add_batch(["a", "a", "b", "c"])
b1 = run_once()
add_batch(["a", "c", "c", "d"])
b2 = run_once()
print("N-1 =", b1, "N =", b2)
new = counts(b2, "count_N")
old = counts(b1, "count_N_minus_1")
new.join(old, "word", "full_outer").orderBy("word").show()
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/01 19:31:42 INFO SparkContext: Running Spark version 4.0.4
26/11/01 19:31:42 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/01 19:31:42 INFO SparkContext: Java version 17.0.19
26/11/01 19:31:42 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/01 19:31:52 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/01 19:31:56 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/01 19:31:57 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:57 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:57 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:57 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
N-1 = 0 N = 1
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 1 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:31:58 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+----+-------+---------------+
|word|count_N|count_N_minus_1|
+----+-------+---------------+
|   a|      3|              2|
|   b|      1|              1|
|   c|      3|              1|
|   d|      1|           NULL|
+----+-------+---------------+
Разница между двумя соседними версиями видна сразу. Слово a выросло с 2 до 3, c с 1 до 3, d появилось впервые (NULL в старой версии), а b не изменилось. Здесь же batchId был 0 и 1, а в логе встречаются версии 1 и 2. Какая версия относится к какому из двух чтений, лог не различает, поэтому соответствие версий и номеров батчей прогон не показал. Зато на чистых каталогах счётчики совпали с ожидаемыми значениями.
Задание 2. Для запроса с dropDuplicates и watermark прочитайте состояние после каждого из трёх запусков, посчитайте число записей и сравните его с тем, что ожидаете от очистки по watermark.
Решение
Сделаем три запуска. Первый кладёт в состояние три ключа со временем около 12:00, второй добавляет событие на 13:00, третий добавляет событие на 13:01. Смотрим, сколько ключей остаётся после каждого запуска.
# task2.py · PySpark 4.0.4 · Spark 4.0.4
from datetime import datetime
from pyspark.sql import SparkSession

spark = (SparkSession.builder.appName("task2")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.sql.session.timeZone", "UTC")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

IN, CKPT = "/tmp/t2_in", "/tmp/t2_ckpt"


def add_events(rows):
    df = spark.createDataFrame(rows, "id string, ts timestamp")
    df.write.mode("append").json(IN)


def run_once():
    src = spark.readStream.schema("id string, ts timestamp").json(IN)
    dedup = (src.withWatermark("ts", "10 minutes")
             .dropDuplicates(["id", "ts"]))
    q = (dedup.writeStream.outputMode("append")
         .format("noop")
         .option("checkpointLocation", CKPT)
         .trigger(availableNow=True).start())
    q.awaitTermination()


def show_state(title):
    print(title)
    st = spark.read.format("statestore").load(CKPT)
    st.groupBy("partition_id").count().orderBy("partition_id").show()
    st.select("key.id", "key.ts").orderBy("ts", "id").show(truncate=False)


add_events([("a", datetime(2025, 1, 1, 12, 0)),
            ("b", datetime(2025, 1, 1, 12, 0)),
            ("c", datetime(2025, 1, 1, 12, 1))])
run_once()
show_state("после запуска 1")

add_events([("d", datetime(2025, 1, 1, 13, 0))])
run_once()
show_state("после запуска 2")

add_events([("e", datetime(2025, 1, 1, 13, 1))])
run_once()
show_state("после запуска 3")
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/01 19:32:02 INFO SparkContext: Running Spark version 4.0.4
26/11/01 19:32:02 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/01 19:32:02 INFO SparkContext: Java version 17.0.19
26/11/01 19:32:03 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/01 19:32:13 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
после запуска 1
26/11/01 19:32:17 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:17 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:17 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:17 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+------------+-----+
|partition_id|count|
+------------+-----+
|           0|    2|
|           2|    1|
+------------+-----+

26/11/01 19:32:18 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:18 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:18 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:18 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+---+-------------------+
|id |ts                 |
+---+-------------------+
|a  |2025-01-01 12:00:00|
|b  |2025-01-01 12:00:00|
|c  |2025-01-01 12:01:00|
+---+-------------------+

26/11/01 19:32:19 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
26/11/01 19:32:19 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:19 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:19 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:19 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
после запуска 2
26/11/01 19:32:20 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:20 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:20 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:20 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+------------+-----+
|partition_id|count|
+------------+-----+
|           2|    1|
+------------+-----+

26/11/01 19:32:21 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:21 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:21 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:21 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+---+-------------------+
… (пропущено строк: 6)
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 4 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
после запуска 3
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:22 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+------------+-----+
|partition_id|count|
+------------+-----+
|           0|    1|
|           2|    1|
+------------+-----+

26/11/01 19:32:23 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:23 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:23 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:23 WARN HDFSBackedStateStoreProvider: The state for version 6 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+---+-------------------+
|id |ts                 |
+---+-------------------+
|d  |2025-01-01 13:00:00|
|e  |2025-01-01 13:01:00|
+---+-------------------+
Прогон показывает следующее. После запуска 1 в состоянии три ключа (a, b и c). После запуска 2 число ключей сократилось с трёх до одного, и этот ключ лежит в партиции 2. Какой именно это ключ, вывод не показывает, потому что строки этого чтения в блоке пропущены. После запуска 3 в таблице два ключа, d и e. Такая картина согласуется с очисткой по watermark, ведь события около 12:00 ушли, когда появилось событие на 13:00. Но сам механизм прогон не доказывает, потому что между запусками мы состояние не читали и watermark не выводили. Версии состояния в этих трёх чтениях были 2, 4 и 6. Распределение по partition_id тут ничего не объясняет, оно лишь показывает, в каких партициях лежат ключи.
Ключ дедупликации в этом запросе включает время события (id и ts). Что произошло бы при ключе только id, мы отдельным прогоном не проверяли и утверждать не берёмся.
Задание 3. Через state-metadata получите operatorId и имя оператора для запроса с двумя stateful-операторами (дедупликация и оконная агрегация) и прочитайте состояние каждого.
Решение
# task3.py · PySpark 4.0.4 · Spark 4.0.4
from datetime import datetime
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = (SparkSession.builder.appName("task3")
         .config("spark.sql.shuffle.partitions", "4")
         .config("spark.sql.session.timeZone", "UTC")
         .getOrCreate())
spark.sparkContext.setLogLevel("WARN")

IN, CKPT = "/tmp/t3_in", "/tmp/t3_ckpt"

rows = [("e1", "a", datetime(2025, 1, 1, 12, 0)),
        ("e2", "a", datetime(2025, 1, 1, 12, 1)),
        ("e1", "a", datetime(2025, 1, 1, 12, 0)),
        ("e3", "b", datetime(2025, 1, 1, 12, 2))]
spark.createDataFrame(rows, "id string, word string, ts timestamp") \
    .write.mode("append").json(IN)

src = spark.readStream.schema("id string, word string, ts timestamp").json(IN)
agg = (src.withWatermark("ts", "10 minutes")
       .dropDuplicates(["id", "ts"])
       .groupBy(F.window("ts", "10 minutes"), "word").count())
q = (agg.writeStream.outputMode("append")
     .format("noop")
     .option("checkpointLocation", CKPT)
     .trigger(availableNow=True).start())
q.awaitTermination()

meta = spark.read.format("state-metadata").load(CKPT)
meta.show(truncate=False)
for row in meta.orderBy("operatorId").collect():
    op = row["operatorId"]
    print("operatorId =", op, "operatorName =", row["operatorName"])
    st = (spark.read.format("statestore")
          .option("operatorId", op).load(CKPT))
    st.printSchema()
    st.show(truncate=False)
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/01 19:32:27 INFO SparkContext: Running Spark version 4.0.4
26/11/01 19:32:27 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/01 19:32:27 INFO SparkContext: Java version 17.0.19
26/11/01 19:32:27 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/01 19:32:37 WARN ResolveWriteToStream: spark.sql.adaptive.enabled is not supported in streaming DataFrames/Datasets and will be disabled.
+----------+--------------+--------------+-------------+----------+----------+------------------+
|operatorId|operatorName  |stateStoreName|numPartitions|minBatchId|maxBatchId|operatorProperties|
+----------+--------------+--------------+-------------+----------+----------+------------------+
|0         |stateStoreSave|default       |4            |0         |1         |NULL              |
|1         |dedupe        |default       |4            |0         |1         |NULL              |
+----------+--------------+--------------+-------------+----------+----------+------------------+

operatorId = 0 operatorName = stateStoreSave
root
 |-- key: struct (nullable = true)
 |    |-- window: struct (nullable = false)
 |    |    |-- start: timestamp (nullable = true)
 |    |    |-- end: timestamp (nullable = true)
 |    |-- word: string (nullable = true)
 |-- value: struct (nullable = true)
 |    |-- count: long (nullable = false)
 |-- partition_id: integer (nullable = true)

26/11/01 19:32:43 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:43 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:43 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:43 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+-----------------------------------------------+-----+------------+
|key                                            |value|partition_id|
+-----------------------------------------------+-----+------------+
|{{2025-01-01 12:00:00, 2025-01-01 12:10:00}, a}|{2}  |3           |
|{{2025-01-01 12:00:00, 2025-01-01 12:10:00}, b}|{1}  |3           |
+-----------------------------------------------+-----+------------+

operatorId = 1 operatorName = dedupe
root
 |-- key: struct (nullable = true)
 |    |-- id: string (nullable = true)
 |    |-- ts: timestamp (nullable = true)
 |-- value: struct (nullable = true)
 |    |-- __dummy__: void (nullable = true)
 |-- partition_id: integer (nullable = true)

26/11/01 19:32:44 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:44 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:44 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
26/11/01 19:32:44 WARN HDFSBackedStateStoreProvider: The state for version 2 doesn't exist in loadedMaps. Reading snapshot file and delta files if needed...Note that this is normal for the first batch of starting query.
+-------------------------+------+------------+
|key                      |value |partition_id|
+-------------------------+------+------------+
|{e1, 2025-01-01 12:00:00}|{NULL}|1           |
|{e3, 2025-01-01 12:02:00}|{NULL}|1           |
|{e2, 2025-01-01 12:01:00}|{NULL}|2           |
+-------------------------+------+------------+
Метаданные показывают два оператора. Оператор 0 это stateStoreSave с оконной агрегацией, ключ у него содержит окно и слово, а значение счётчик. Оператор 1 это dedupe, ключ у него пара id и ts, а значение пустое. Дубликат события e1 в состояние попал один раз, поэтому ключей три при четырёх входных строках. В агрегации счётчик слова a равен 2, потому что e1 и e2 различны, а повтор e1 отброшен дедупликацией. Здесь счётчики согласуются с входом, в отличие от основного примера. Без опции operatorId чтение в таком запросе неоднозначно, поэтому её стоит задавать явно.
Что делать дальше
Чтение состояния полезно, когда вы разбираете реальный инцидент, но навык работы со стримингом шире одного формата. Систематически триггеры, режимы вывода, watermark и чекпоинты разбираются в курсе Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX.
Референсные ссылки
- Пост о State Data Source в Spark 4 на Medium, исходник статьи.
- SPARK-45511 в Apache Jira, предложение о ридере состояния.
- Structured Streaming Programming Guide, APIs on DataFrames and Datasets, источники, операции, watermark.
- Structured Streaming Programming Guide, Performance Tips, continuous processing и ограничения.