Если нужно дать сервису или CI-джобе доступ к Spark, а ставить на каждый узел Java и полный дистрибутив не хочется, пригодится pyspark-client Spark Connect thin client, то есть чистый Python-клиент из Spark 4. По документации он не зависит от jar-файлов и JRE и отправляет работу на удалённый сервер. Взамен он лишается части привычного API. В статье разбираем, где проходит граница, и проверяем её на стенде. Оговорка важная. Сам пакет pyspark-client на нашем стенде не запускался, а границы API проверялись в режиме Connect на полном pyspark из образа Spark.
Что такое pyspark-client и зачем клиенту Spark 4 не нужна JVM
В документации по установке PySpark сказано, что Python Spark Connect client (пакет pyspark-client на PyPI) это чистая Python-библиотека, которая не зависит от jar-файлов и JRE. Пакет поддерживает только spark.remote с URI, у которого схема sc, например с адресом localhost. Запустить с ним локальный Spark в режиме local[*] нельзя, он умеет лишь подключаться к уже работающему серверу.
Для сравнения, обычный pyspark по той же странице требует Java 17 или новее и зависит от py4j, который нужен для общения с JVM. Между ними есть и третий пакет, pyspark-connect. Он ставит полный pyspark вместе с зависимостями Connect и делает Connect режимом по умолчанию. Получается три варианта установки с разным составом, и выбирать между ними нужно осознанно.
Разбор исходника, что проверил автор и какие выводы сделал
Исходник это заметка «PySpark Without a JVM» на Medium. Автор поднял локальный сервер Spark Connect и направил на него чистый Python-клиент версии 4.1.1. Главная мысль в том, что сам пакет клиента невелик, но тянет за собой pandas, pyarrow и grpcio, поэтому окружение получается заметно тяжелее, чем можно ожидать. Атрибуты вроде sparkContext, df.rdd и df._jdf недоступны, а настройки SQL на уровне сессии менять можно.
Самая практичная часть заметки про три привычки, которые тихо меняют смысл в Connect. Ошибка в имени столбца проявляется не сразу, а когда что-то запросит разрешённый план. Датафрейм хранит имя временного представления, поэтому после его пересоздания вернёт другие строки. Функция UDF сериализуется в момент действия, поэтому видит более позднее значение переменной. Лечится это уникальными именами представлений и небольшой фабрикой для UDF.
Тезис «клиент без JVM работает против сервера, но часть API недоступна» подтверждается и официальным обзором Spark Connect. Дальше мы проверяем границы сами, а выводы берём из реального прогона.
Как устроен Spark Connect под капотом
По документации Spark Connect появился в Spark 3.4 как архитектура с разделением клиента и сервера. Клиент переводит операции DataFrame в неразрешённые логические планы (unresolved logical plan), кодирует их через protocol buffers и отправляет на сервер по gRPC. Сервер превращает их в обычные логические операторы Spark, дальше работает стандартный конвейер оптимизации и выполнения. Результаты возвращаются клиенту потоком батчей строк в формате Apache Arrow. Порт по умолчанию 15002.
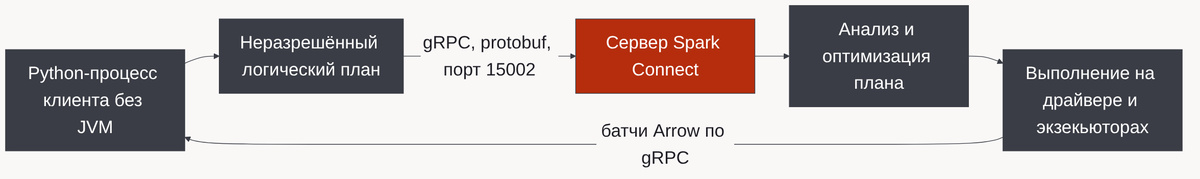
Из этой схемы следуют ограничения. Клиент живёт в другом процессе, чем драйвер Spark, поэтому py4j не используется и приватные поля вроде df._jdf недоступны. Протокол описывает операции декларативно через логические планы, поэтому он не поддерживает все исполняющие API Spark, и в первую очередь RDD. Клиент работает в рамках сессии и не видит статическую конфигурацию Spark и SparkContext.
Платой за это стали операционные плюсы. Приложение с утечкой памяти валит только свой процесс. Зависимости клиента не конфликтуют с зависимостями драйвера, а сам драйвер можно обновлять независимо от приложений. Встроенной аутентификации у Spark Connect нет, документация предлагает ставить перед ним аутентифицирующий прокси, раз gRPC работает поверх HTTP/2.
Как клиент находит сервер
Способов подключения несколько. Первый это переменная окружения SPARK_REMOTE с адресом сервера. Если она задана на машине клиента, обычный код создания сессии автоматически станет Connect-сессией и менять его не придётся. Второй способ это явный вызов builder.remote с URI, именно его используют наши примеры. Третий это флаг —remote у оболочки bin/pyspark. Если не применить ни один из них, сессия работает как раньше, без Connect.
В строке подключения можно передавать и параметры, документация показывает пример с токеном, который указывается после хоста и порта через точку с запятой. Проверить, что сессия действительно Connect, можно по имени класса. Если в нём есть .connect., вы работаете через Spark Connect, и наш первый пример печатает именно этот признак.
Что доступно тонкому клиенту, а что нет
Документация говорит, что с Spark 3.4 Connect поддерживает большинство API PySpark, включая DataFrame, Functions и Column, а SparkContext и RDD не поддерживаются. Поддерживаемые методы в справочнике помечены как «Supports Spark Connect». Для пакета pyspark[connect] нужны pandas, pyarrow, grpcio, grpcio-status и googleapis-common-protos, минимальные версии указаны на странице установки.
Сравним три варианта установки. Данные взяты из документации по установке и из обзора Spark Connect.
| Критерий | pyspark | pyspark-connect | pyspark-client |
|---|---|---|---|
| Что нужно на клиенте | Java 17 или новее, py4j | полный pyspark и зависимости Connect | чистый Python, без jar и JRE |
| Режим подключения | классический, Connect включается через SPARK_REMOTE или builder.remote | spark.master и spark.remote, включая local[*] | только spark.remote с URI |
| RDD и SparkContext | доступны в классическом режиме, в режиме Connect нет | в режиме Connect не поддерживаются | не поддерживаются в Connect |
| Где выполняется план | драйвер в процессе приложения, в режиме Connect на сервере | на сервере Connect | на сервере Connect |
Разбор простой. Если нужны RDD или доступ к JVM, берите полный pyspark в классическом режиме. Если нужен локальный Spark и одновременно Connect по умолчанию, подойдёт pyspark-connect. Если приложение только строит DataFrame и SQL-запросы, а считает удалённый сервер, достаточно pyspark-client, но помните про зависимости pandas, pyarrow и grpcio, которые делают окружение тяжелее самого пакета.
Практика, Connect-сервер в контейнере
На хосте нет Java, поэтому сервер Spark Connect поднимаем в контейнере spark из образа apache/spark:4.0.4-scala2.13-java17-python3-ubuntu. Примеры запускает раннер стенда командой spark-submit внутри этого же контейнера, а сессию мы создаём через builder.remote, то есть работаем в режиме Connect. Это проверка границ API Connect, но не проверка пакета pyspark-client и не проверка отсутствия JVM на клиенте, потому что в контейнере установлен полный pyspark. Прогон с pyspark-client в отдельном venv вынесен в задание 3. Версия документации здесь 4.0.0, а образ 4.0.4, поэтому всё поведение сверяем по реальному выводу.
Сначала стенд. Каталог /work смонтирован только на чтение, поэтому логи сервера и зависимости клиента кладём в /tmp. Каталог /tmp/deps добавлен в PYTHONPATH, туда run.sh ставит зависимости Connect из списка документации. Сам pyspark берётся из образа.
# compose.yaml · apache/spark 4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    command: ["sleep", "infinity"]
    mem_limit: 3g
    ports:
      - "127.0.0.1:15002:15002"
    environment:
      PYTHONPATH: /tmp/deps
      SPARK_LOG_DIR: /tmp/spark-logs
      SPARK_PID_DIR: /tmp/spark-pids
    volumes:
      - ./:/work:ro
Скрипт run.sh поднимает стенд, ставит зависимости, запускает start-connect-server.sh, ждёт открытия порта 15002 и запускает основной пример. Стенд он не гасит.
#!/usr/bin/env bash
# run.sh · Spark 4.0.4 · Spark Connect
set -euo pipefail
docker compose up -d --wait
docker compose exec -T spark mkdir -p /tmp/spark-logs /tmp/spark-pids /tmp/deps
docker compose exec -T spark python3 -m pip install --quiet --target /tmp/deps "grpcio>=1.67.0" "grpcio-status>=1.67.0" "googleapis-common-protos>=1.65.0" "pandas>=2.0.0" "pyarrow>=11.0.0"
docker compose exec -T spark /opt/spark/sbin/start-connect-server.sh
for i in $(seq 1 60); do
  if docker compose exec -T spark bash -c 'exec 3<>/dev/tcp/127.0.0.1/15002' 2>/dev/null; then break; fi
  sleep 2
done
sleep 3
docker compose exec -T spark /opt/spark/bin/spark-submit --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false /work/connect_basic.py
Основной пример создаёт Connect-сессию, печатает модуль класса сессии (по документации в Connect-режиме в имени есть connect), версию сервера и считает агрегат двумя способами, через DataFrame API и через spark.sql. Вызова setLogLevel на SparkContext здесь нет, потому что SparkContext клиенту недоступен, а уровень логов задаёт флаг запуска.
# connect_basic.py · Spark 4.0.4 · Spark Connect
import os
from pyspark.sql import SparkSession, functions as F

os.environ.pop("MASTER", None)
SparkSession.builder._options.pop("spark.master", None)
spark = SparkSession.builder.remote("sc://localhost:15002").appName("basic").getOrCreate()

print("модуль сессии:", type(spark).__module__)
print("версия сервера:", spark.version)

df = spark.createDataFrame(
    [("eu", "a", 10), ("eu", "b", 5), ("us", "a", 7), ("us", "b", 12), ("us", "c", 1)],
    ["region", "product", "amount"],
)

df.groupBy("region").agg(F.sum("amount").alias("total"), F.count("*").alias("n")).orderBy("region").show()

df.createOrReplaceTempView("sales")
spark.sql("SELECT product, SUM(amount) AS total FROM sales GROUP BY product ORDER BY product").show()

spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
модуль сессии: pyspark.sql.connect.session
версия сервера: 4.0.4
+------+-----+---+
|region|total|  n|
+------+-----+---+
|    eu|   15|  2|
|    us|   20|  3|
+------+-----+---+

+-------+-----+
|product|total|
+-------+-----+
|      a|   17|
|      b|   17|
|      c|    1|
+-------+-----+

26/11/01 19:35:34 INFO ShutdownHookManager: Shutdown hook called
26/11/01 19:35:34 INFO ShutdownHookManager: Deleting directory /tmp/spark-d7ed3076-608f-49ff-b3d8-d2c5e4c9f397
Прогон подтвердил две вещи. Сессия принадлежит модулю pyspark.sql.connect.session, то есть это действительно Connect, а версия сервера 4.0.4 совпадает с образом. Агрегаты через DataFrame API и через spark.sql посчитаны на сервере и вернулись клиенту без изменений в коде.
Теперь границы. Следующий скрипт пробует то, что в Connect недоступно, а именно SparkContext, RDD и приватное поле _jdf. Каждую попытку он оборачивает в перехват и печатает имя класса исключения и начало сообщения.
# connect_limits.py · Spark 4.0.4 · Spark Connect
import os
from pyspark.sql import SparkSession

os.environ.pop("MASTER", None)
SparkSession.builder._options.pop("spark.master", None)
spark = SparkSession.builder.remote("sc://localhost:15002").appName("limits").getOrCreate()
df = spark.range(3)


def probe(name, fn):
    try:
        fn()
        print(name, "-> работает")
    except Exception as e:
        text = str(e).strip().splitlines()[0][:110] if str(e).strip() else ""
        print(name, "->", type(e).__name__, "|", text)


probe("spark.sparkContext", lambda: spark.sparkContext)
probe("df.rdd", lambda: df.rdd)
probe("df._jdf", lambda: df._jdf)
probe("df.count()", lambda: df.count())

spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
spark.sparkContext -> PySparkAttributeError | [JVM_ATTRIBUTE_NOT_SUPPORTED] Attribute `sparkContext` is not supported in Spark Connect as it depends on the
df.rdd -> PySparkNotImplementedError | [NOT_IMPLEMENTED] rdd is not implemented.
df._jdf -> PySparkAttributeError | [JVM_ATTRIBUTE_NOT_SUPPORTED] Attribute `_jdf` is not supported in Spark Connect as it depends on the JVM. If
df.count() -> работает
26/11/01 19:35:39 INFO ShutdownHookManager: Shutdown hook called
26/11/01 19:35:39 INFO ShutdownHookManager: Deleting directory /tmp/spark-11d6610e-d668-40c4-a67a-f7c371704050
Прогон показал границы протокола. Обращение к sparkContext и к _jdf даёт PySparkAttributeError с кодом JVM_ATTRIBUTE_NOT_SUPPORTED, и сообщение прямо объясняет, что атрибут зависит от JVM. Обращение к df.rdd на версии 4.0.4 даёт PySparkNotImplementedError с кодом NOT_IMPLEMENTED, тогда как автор исходника на 4.1.1 получил для df.rdd JVM_ATTRIBUTE_NOT_SUPPORTED. Код ошибки, видимо, отличается между версиями, но суть одна, RDD в Connect нет. Обычное действие df.count() работает. В прогоне исключения были получены уже при обращении к атрибуту. Сколько времени проходит до ошибки относительно расчёта на сервере, прогон не измерял. Стенд работает на полном pyspark в режиме Connect, поэтому для pyspark-client эти ограничения следуют из протокола Connect, а не из отдельного запуска.
Последняя проверка показывает на практике, что значит «код выполняется на сервере». Python UDF определяется на клиенте, а исполняется на стороне сервера. Вместе с обычным UDF проверим pandas UDF, который опирается на Arrow, и сравним версии Python на двух сторонах.
# udf_check.py · Spark 4.0.4 · Spark Connect
import os
import sys
import pandas as pd
from pyspark.sql import SparkSession, functions as F

os.environ.pop("MASTER", None)
SparkSession.builder._options.pop("spark.master", None)
spark = SparkSession.builder.remote("sc://localhost:15002").appName("udf").getOrCreate()


@F.udf("string")
def server_python():
    import sys as s
    return ".".join(map(str, s.version_info[:3]))


@F.pandas_udf("long")
def plus_one(s: pd.Series) -> pd.Series:
    return s + 1


client = ".".join(map(str, sys.version_info[:3]))
server = spark.range(1).select(server_python()).first()[0]
print("Python клиента:", client)
print("Python сервера:", server)
print("pandas UDF:", [r[0] for r in spark.range(3).select(plus_one("id")).collect()])

spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
Python клиента: 3.10.12
Python сервера: 3.10.12
pandas UDF: [1, 2, 3]
26/11/01 19:35:47 INFO ShutdownHookManager: Shutdown hook called
26/11/01 19:35:47 INFO ShutdownHookManager: Deleting directory /tmp/spark-506dd451-e619-4b03-9f6f-a1f90ae80ae4
В этом стенде клиент и сервер используют один интерпретатор (3.10.12), поэтому оба UDF отработали. Функция server_python вернула версию Python именно серверной стороны, то есть её тело действительно выполнялось на сервере. Что произойдёт при несовпадении версий, прогон не проверял, и надёжного правила на этот счёт мы не утверждаем. Эту проверку делает задание 3.
Задания
Задачи ниже закрепляют границы API. Решения первых двух тоже прогоняются на стенде, третье остаётся сценарием для вашей машины.
- Задание 1. Проверьте, какие операции DataFrame API работают через Connect (select, filter, groupBy, join, window, spark.sql), и выведите таблицу «работает или ошибка».
- Задание 2. Покажите, что RDD недоступен, и перепишите word count на DataFrame API.
- Задание 3. Установите pyspark-client в отдельный venv и проверьте, как ведёт себя UDF при разных версиях Python на клиенте и сервере.
Три задачи покрывают границы API, а третья закрывает главный пробел статьи, то есть настоящий тонкий клиент. Начнём с первого, где нужна единая функция проверки.
Решение задания 1
# ops_check.py · Spark 4.0.4 · Spark Connect
import os
from pyspark.sql import SparkSession, Window, functions as F

os.environ.pop("MASTER", None)
SparkSession.builder._options.pop("spark.master", None)
spark = SparkSession.builder.remote("sc://localhost:15002").appName("ops").getOrCreate()

a = spark.createDataFrame([(1, "x", 10), (2, "x", 20), (3, "y", 5)], ["id", "k", "v"])
b = spark.createDataFrame([("x", "первый"), ("y", "второй")], ["k", "name"])
a.createOrReplaceTempView("a")

ops = {
    "select": lambda: a.select("id", (F.col("v") * 2).alias("v2")).collect(),
    "filter": lambda: a.filter(F.col("v") > 5).collect(),
    "groupBy": lambda: a.groupBy("k").agg(F.sum("v")).collect(),
    "join": lambda: a.join(b, "k").collect(),
    "window": lambda: a.withColumn("rn", F.row_number().over(Window.partitionBy("k").orderBy("v"))).collect(),
    "spark.sql": lambda: spark.sql("SELECT k, MAX(v) FROM a GROUP BY k").collect(),
}

for name, fn in ops.items():
    try:
        rows = fn()
        print(f"{name:10} работает, строк: {len(rows)}")
    except Exception as e:
        print(f"{name:10} ошибка {type(e).__name__}")

spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
select     работает, строк: 3
filter     работает, строк: 2
groupBy    работает, строк: 2
join       работает, строк: 3
window     работает, строк: 3
spark.sql  работает, строк: 2
26/11/01 19:35:54 INFO ShutdownHookManager: Shutdown hook called
26/11/01 19:35:54 INFO ShutdownHookManager: Deleting directory /tmp/spark-5101996b-6180-4fdd-9cc6-026fcdf7a26a
Теперь второе. Классический word count на RDD строится на flatMap и reduceByKey. В Connect то же получается через explode и groupBy, а оптимизатор Spark применяет к плану привычные правила.
Решение задания 2
# wordcount_df.py · Spark 4.0.4 · Spark Connect
import os
from pyspark.sql import SparkSession, functions as F

os.environ.pop("MASTER", None)
SparkSession.builder._options.pop("spark.master", None)
spark = SparkSession.builder.remote("sc://localhost:15002").appName("wc").getOrCreate()

lines = spark.createDataFrame(
    [("Spark Connect отправляет план по gRPC",), ("клиент без JVM отправляет план",), ("spark connect",)],
    ["line"],
)

words = lines.select(F.explode(F.split(F.lower("line"), r"\s+")).alias("word"))
words.groupBy("word").count().orderBy(F.desc("count"), "word").show()

spark.stop()
WARNING: Using incubator modules: jdk.incubator.vector
+----------+-----+
|      word|count|
+----------+-----+
|   connect|    2|
|     spark|    2|
|отправляет|    2|
|      план|    2|
|      grpc|    1|
|       jvm|    1|
|       без|    1|
|    клиент|    1|
|        по|    1|
+----------+-----+

26/11/01 19:36:02 INFO ShutdownHookManager: Shutdown hook called
26/11/01 19:36:02 INFO ShutdownHookManager: Deleting directory /tmp/spark-8ffcf932-93f4-4f3e-ad65-bbfad40ddaae
С третьим заданием поможет уже написанный udf_check.py, он печатает обе версии. Чтобы получить настоящий тонкий клиент без JVM, создайте отдельный venv на хосте, лучше с другой версией Python, чем у сервера, и поставьте в него pyspark-client. Подключитесь к порту 15002 на адресе 127.0.0.1 и вызовите тот же UDF. Ниже только сценарий установки. Мы его на стенде не запускали, поэтому ни результат, ни возможную ошибку при расхождении версий не обещаем, это нужно проверить своим запуском.
Решение задания 3
# client_venv.sh · pyspark-client · Spark Connect
python3 -m venv .venv-client
.venv-client/bin/pip install pyspark-client
.venv-client/bin/pip install "pandas>=2.0.0" "pyarrow>=11.0.0" "grpcio>=1.67.0" "grpcio-status>=1.67.0" "googleapis-common-protos>=1.65.0"
.venv-client/bin/python udf_check.py
Полученную ошибку или её отсутствие полезно сохранить в заметках проекта, так будет проще отлаживать боевые сервисы. Заодно можно сравнить размер этого окружения с размером окружения обычного pyspark. Если вы прогоните этот сценарий, вы закроете две оговорки статьи сразу, про отсутствие JVM на клиенте и про поведение UDF при разных версиях Python.
Что дальше
Если вы хотите системно разобраться в DataFrame API, Spark SQL и потоковой обработке, которые доступны через Connect, загляните на курс Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX. Там эти темы разобраны на практике. А для понимания RDD и классической модели выполнения, которой Connect не касается, подойдёт Основы Apache Spark.