В прошлый раз мы рассмотрели 6 способов повышения производительности Apache Spark: кэширование, трансляция, бакетирование, минимизация перетасовки (shuffle), применение оконных функций и контрольных точек. Дадим еще...
6 способов повышения производительности в Apache Spark
Apache Spark применяется для работы с большими данными (Big Data), поэтому встает вопрос: как увеличить скорости обработки этих данных. В этой статье мы рассмотрим 5...
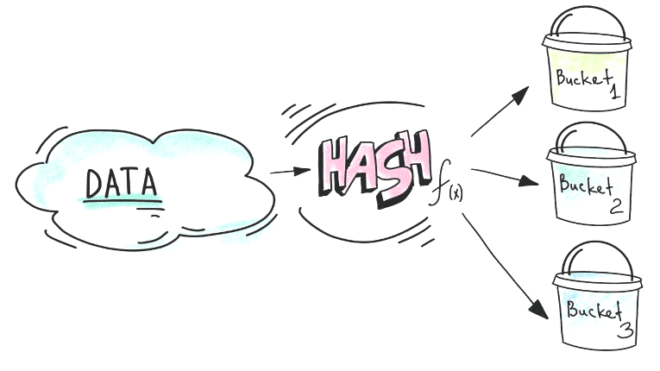
Зачем вам бакетирование в Apache Spark
В предыдущей статье мы поговорили о разнице между партициями и бакетами Apache Spark. Сегодня на реальном примере покажем, как бакетирование помогает писать оптимизированные запросы без...
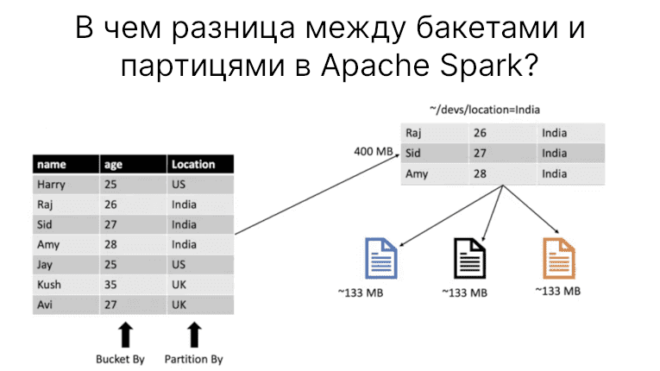
В чем разница между партициями и бакетами
При оптимизации работы Apache Spark рекомендуют делать партиции и бакеты. Однако в чем разница между партицированием и бакетированием? В этой статье мы разберемся в этом....
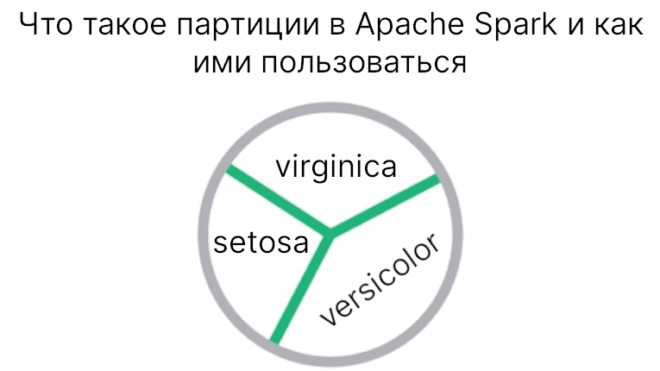
Как разбить датасет на партиции с помощью partitionby
Чтение больших данных (Big Data) занимает время. Одним из способов работы с большими объемам является разбиение большого датасет на части, или партиции. Сегодня мы поговорим...
Ускоритель RAPIDS 22.02 и 21.10 для Apache Spark
В прошлой статье мы говорили об ускорителе RAPIDS для Apache Spark. Сегодня рассмотрим, что появилось в версии RAPIDS 21.10 (релиз за январь) и 22.02 (релиз...
Вы этого ждали: Apache Spark 3.0 работает с GPU
NVIDIA работает вместе с разработчиками библиотек Apache Spark и RAPIDS для реализации ускорения GPU. Наконец-то в Apache Spark можно проводить обработку данных на GPU. В...
Функции PySpark SQL для работы с JSON
В предыдущий раз мы говорили о чтение и записи JSON файлов в PySpark. Сегодня затронем функции для работы с JSON. Читайте в этой статье: как...

10 вопросов на знание основ работы с JSON и Hive в Spark: открытый интерактивный тест для начинающих изучать Spark SQL
Чтобы самостоятельное обучение по Spark стало еще интереснее, сегодня мы предлагаем вам простой тест по основам работы с такими Big Data хранилищами (форматами), как Hive...
Работаем с файлами JSON в PySpark: читаем и записываем
Сегодня расскажем, как работать с файлами формата JSON в PySpark. В этой статье вы узнаете: как прочитать файл JSON, каким должен быть формат, чтобы PySpark...