Подзапросы в PySpark через DataFrame API (PySpark subqueries DataFrame API) долго оставались слабым местом. Как только нужен коррелированный подзапрос (correlated subquery), приходилось регистрировать временные представления и писать SQL-строку в spark.sql() либо переписывать всё на groupBy и join. В Spark 4.0 для этого появились методы scalar(), exists(), outer() и lateralJoin(). Разберём, как они работают, во что превращаются в плане и где проходят границы версий, а затем проверим всё на стенде со Spark 4.0.4.
Что пишет исходник и чем статья его дополняет
Автор разбора на Medium пересобрал привычные SQL-шаблоны на новых методах и посмотрел, во что их превращает оптимизатор. Оригинал называется Subqueries Without SQL Strings. Все примеры там запускались на PySpark 4.1.1 в локальном режиме на четырёх клиентах и шести заказах. У клиента Kabir заказов нет специально, потому что пустые совпадения и есть самое интересное место подзапросов.
Главное из исходника коротко. Метод scalar() превращает DataFrame из одной строки и одного столбца в колонку и избавляет от пути через first()[0] с возвратом числа в драйвер. Метод exists() возвращает булеву колонку, а её отрицание заменяет left_anti join. Метод outer() помечает ссылку на строку внешнего запроса. Метод lateralJoin() позволяет правой стороне вернуть любое число строк для каждой левой, поэтому подходит для задачи «последние N заказов клиента». По словам автора, методы подзапросов появились в версии 4.0, а передача DataFrame в isin() относится к версии 4.1.0. Эту границу мы сами не проверяли, а прогон на 4.0.4 подтверждает только то, что isin(DataFrame) там не работает.
У исходника есть три ограничения. Он запускался на 4.1.1, а наш стенд работает на 4.0.4. Планы получены на микроданных, где выбор стратегии соединения ничего не говорит о боевой нагрузке. И сравнения с другими способами записи той же задачи там нет. Поэтому мы запустим всё на 4.0.4 и сравним пять способов записать один запрос. Отдельно проверим, что происходит с isin() на DataFrame в версии 4.0.4. Если вы только осваиваете планы запросов и соединения, удобно сначала пройти курс по Spark SQL.
Как устроены scalar, exists, outer и lateralJoin под капотом
Все четыре метода превращают DataFrame в выражение подзапроса внутри логического плана. Документация Spark говорит, что при вычислении результата работает один и тот же движок независимо от API, SQL или Dataset. Из этого не следует, что планы будут одинаковыми, поэтому мы сверим и результаты через exceptAll, и планы на конкретных данных.
scalar и exists
Скалярный подзапрос (scalar subquery) обязан вернуть ровно одну строку и один столбец. Если столбцов больше, ошибка возникает на этапе анализа, это видно по трассировке в выводе. Если строк больше одной, запрос тоже завершается ошибкой, но на каком этапе, наш прогон не различает, потому что внутри обёртки вызывается collect(). Оба правила совпадают с SQL, и в практической части мы напечатаем классы этих ошибок на 4.0.4.
Метод exists() возвращает булеву колонку. По ней можно фильтровать, её можно инвертировать оператором тильды или выбрать как флаг. Для читателя кода важно, что «клиенты без заказов» записывается как отрицание exists, а не как анонимный left_anti join.
outer и алиасы
Коррелированная ссылка в этом API работает по имени, поэтому каждый DataFrame, участвующий в подзапросе, получает алиас, а ссылка на внешнюю строку записывается как F.col(«c.customer_id»).outer(). Если забыть outer(), Spark ищет колонку внутри подзапроса и не находит её. Если вызвать outer() на атрибуте DataFrame вместо F.col, на нашем стенде получилась другая ошибка. Обе мы напечатаем в практической части.
Ещё одна деталь касается Spark Connect. Автор исходника со ссылкой на документацию Column.outer() пишет, что метод нужен для запуска ленивого анализа в Spark Classic, а в Spark Connect DataFrame всегда анализируются лениво. Мы пишем outer() везде, но работу в режиме Connect на стенде не проверяли, все прогоны шли в Classic.
lateralJoin
Метод вызывается как lateralJoin(other, on, how), а в нашем коде мы используем только how=»left». Для задачи «последние два заказа клиента» подзапрос с orderBy и limit(2) зависит от текущего клиента, а how=»left» сохраняет клиента без заказов со значениями NULL. По описанию исходника, с внутренним соединением такой клиент пропал бы.
Во что оптимизатор превращает подзапросы и где проходят границы версий
Исходник показывает, что подзапрос не вычисляется по разу на каждую внешнюю строку, а переписывается в соединения и агрегаты. По его выводу коррелированный скаляр в select даёт LeftOuter join с предагрегированными заказами, exists даёт LeftSemi, отрицание exists даёт LeftAnti, а lateralJoin с limit раскладывается в Window и WindowGroupLimit. Скалярный подзапрос без корреляции остаётся узлом Subquery.
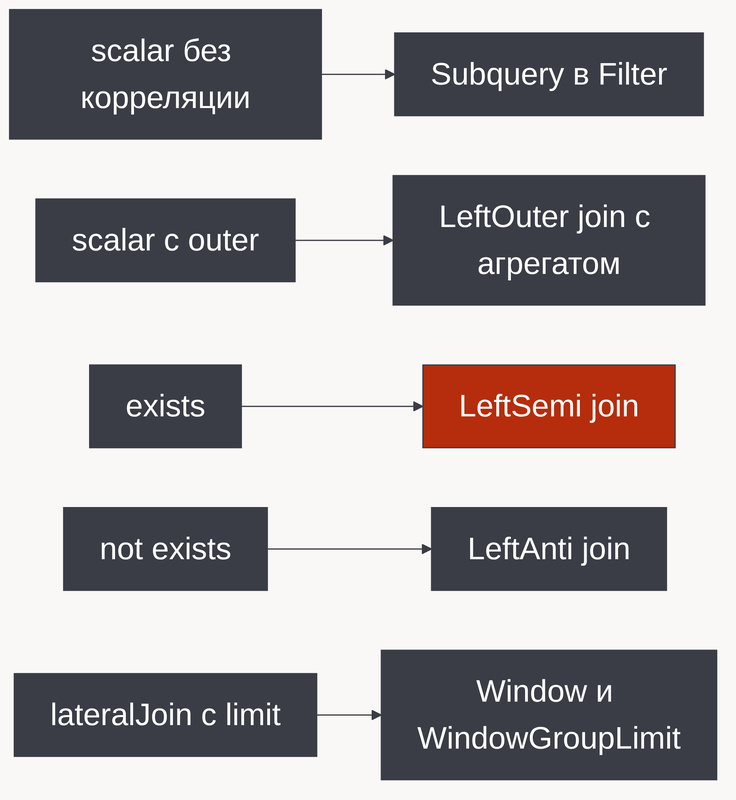
Это описание получено автором исходника на 4.1.1 и микроданных. Мы сравниваем наш прогон на 4.0.4 с этим описанием, а не с собственным прогоном на 4.1.1. В нашем выводе те же типы соединений и те же операторы окна. Документация по настройке производительности напоминает, что алгоритм соединения зависит от порога spark.sql.autoBroadcastJoinThreshold (по умолчанию 10 МБ), а адаптивное выполнение запросов (Adaptive Query Execution, AQE) может заменить sort-merge join на broadcast во время работы. Поэтому мы проверим на 300 тысячах строк, изменится ли тип соединения и алгоритм.
Сравним пять способов записать задачу «заказы выше средней суммы заказов своего клиента». Столбец с планом заполнен по выводу compare.py на 4.0.4 из практической части, на шести строках заказов.
| Способ | Операторы плана на 4.0.4 | Особенность |
|---|---|---|
| SQL-строка через spark.sql | SortMergeJoin (Inner), затем HashAggregate | нужны временные представления и имена в строке |
| Подзапрос DataFrame API | SortMergeJoin (Inner), затем HashAggregate | нужны алиасы и outer() |
| groupBy плюс join | SortMergeJoin (Inner), затем HashAggregate | три шага вместо одного where |
| Оконная функция | только Window, соединения нет | среднее считается по партиции |
| collect в драйвер | соединений и агрегатов в плане нет, среднее посчитано заранее и вшито в запрос | не масштабируется с ростом числа групп |
Выбор такой. Если логика по смыслу является соединением, пишите обычный join, потому что планы подзапроса и groupBy с join совпали по форме. О скорости прогон ничего не говорит, время мы не измеряли. Если читатель должен увидеть «для каждой строки возьми значение из другой таблицы», выигрывает подзапрос, потому что он читается как формулировка задачи. Оконная функция удобна, когда нужны все строки и дополнительная колонка. Вариант с collect годится только для десятка значений, потому что среднее по группам вычисляется отдельным заданием и вшивается в запрос литералами.
Практика на стенде со Spark 4.0.4
На хосте Java нет, поэтому Spark работает в контейнере. Стенд состоит из одного сервиса spark с лимитом памяти 2 ГБ. Каталог с файлами примонтирован только на чтение, поэтому все рабочие каталоги Spark живут в /tmp контейнера.
# compose.yaml · apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
services:
  spark:
    image: apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
    command: ["sleep", "infinity"]
    mem_limit: 2g
    volumes:
      - ./:/work:ro
#!/usr/bin/env bash
# run.sh · Docker Compose · Spark 4.0.4
set -euo pipefail
docker compose up -d --wait
docker compose exec -T spark /opt/spark/bin/spark-submit --conf spark.log.level=WARN --conf spark.ui.showConsoleProgress=false /work/subqueries.py
Общий модуль common.py создаёт сессию, две таблицы из исходника (у клиента Kabir заказов нет) и функции для печати планов. Функция plan_ops оставляет в выводе explain() только операторы соединений, агрегатов, окон и подзапросов вместе с типом соединения.
# common.py · PySpark 4.0.4 · Spark 4.0.4
import contextlib
import io
import re

from pyspark.sql import SparkSession, functions as F


def make_spark():
    spark = (SparkSession.builder.master("local[2]").appName("subqueries")
             .config("spark.sql.shuffle.partitions", "2")
             .config("spark.sql.warehouse.dir", "/tmp/warehouse")
             .config("spark.local.dir", "/tmp")
             .getOrCreate())
    spark.sparkContext.setLogLevel("WARN")
    return spark


def make_data(spark):
    customers = spark.createDataFrame(
        [(1, "Asha", "Hyderabad"), (2, "Ravi", "Pune"),
         (3, "Meera", "Chennai"), (4, "Kabir", "Delhi")],
        "customer_id INT, name STRING, city STRING")
    orders = spark.createDataFrame(
        [(101, 1, "2026-10-28", 1200.0), (102, 1, "2026-11-01", 450.0),
         (103, 1, "2026-11-03", 2300.0), (104, 2, "2026-10-30", 800.0),
         (105, 3, "2026-11-02", 150.0), (106, 3, "2026-11-03", 3100.0)],
        "order_id INT, customer_id INT, order_date STRING, amount DOUBLE"
    ).withColumn("order_date", F.to_date("order_date"))
    return customers, orders


def plan_text(df):
    buf = io.StringIO()
    with contextlib.redirect_stdout(buf):
        df.explain()
    return buf.getvalue()


def plan_ops(label, df):
    ops = []
    for line in plan_text(df).splitlines():
        m = re.search(r"\b(\w*Join|\w*Aggregate|Window\w*|Subquery)\b", line)
        if m and not line.lstrip().startswith("=="):
            jt = re.search(r"\], (LeftOuter|LeftSemi|LeftAnti|Inner)", line)
            op = m.group(1) + (f"({jt.group(1)})" if jt else "")
            if not ops or ops[-1] != op:
                ops.append(op)
    print(f"{label: ".join(ops) or "(нет соединений и агрегатов)")
Основной пример subqueries.py проходит по всем четырём методам. Для клиента без заказов мы ожидаем 0 из count и NULL из sum, а lateral-запрос сверяем с эквивалентным LEFT JOIN LATERAL через exceptAll в обе стороны.
# subqueries.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F
from common import make_spark, make_data, plan_ops

spark = make_spark()
customers, orders = make_data(spark)
c, o = customers.alias("c"), orders.alias("o")


def for_customer(df):
    return df.where(F.col("o.customer_id") == F.col("c.customer_id").outer())


print("--- scalar без корреляции")
overall_avg = orders.select(F.avg("amount")).scalar()
(orders.where(F.col("amount") > overall_avg)
 .select("order_id", "amount", F.round(overall_avg, 2).alias("overall_avg"))
 .orderBy("order_id").show())

print("--- коррелированный scalar")
(c.select("c.name",
          for_customer(o).select(F.count("*")).scalar().alias("n_orders"),
          for_customer(o).select(F.sum("amount")).scalar().alias("total"))
 .orderBy("c.customer_id").show())

print("--- exists и not exists")
has_orders = for_customer(o).exists()
c.where(has_orders).select("name").orderBy("name").show()
c.where(~has_orders).select("name").show()

print("--- lateralJoin, два последних заказа")
latest_two = (for_customer(o)
              .orderBy(F.col("o.order_date").desc())
              .limit(2)
              .select("o.order_id", "o.order_date", "o.amount"))
df_version = (c.lateralJoin(latest_two, how="left")
              .select("name", "order_id", "order_date", "amount"))
df_version.orderBy("name", F.col("order_date").desc()).show()

customers.createOrReplaceTempView("customers")
orders.createOrReplaceTempView("orders")
sql_version = spark.sql("""
    SELECT c.name, t.order_id, t.order_date, t.amount
    FROM customers c
    LEFT JOIN LATERAL (
        SELECT o.order_id, o.order_date, o.amount
        FROM orders o
        WHERE o.customer_id = c.customer_id
        ORDER BY o.order_date DESC
        LIMIT 2
    ) t
""")
print("rows:", sql_version.count(), df_version.count())
print("only in SQL:", sql_version.exceptAll(df_version).count(),
      "| only in DataFrame:", df_version.exceptAll(sql_version).count())

print("--- операторы физических планов")
plan_ops("scalar", orders.where(F.col("amount") > overall_avg))
plan_ops("correlated scalar",
         c.select("c.name", for_customer(o).select(F.sum("amount")).scalar()))
plan_ops("exists", c.where(has_orders))
plan_ops("not exists", c.where(~has_orders))
plan_ops("lateral, LIMIT 2", c.lateralJoin(latest_two, how="left"))
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:21:33 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:21:33 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:21:33 INFO SparkContext: Java version 17.0.19
26/11/04 18:21:34 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:21:34 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
--- scalar без корреляции
+--------+------+-----------+
|order_id|amount|overall_avg|
+--------+------+-----------+
|     103|2300.0|    1333.33|
|     106|3100.0|    1333.33|
+--------+------+-----------+

--- коррелированный scalar
+-----+--------+------+
| name|n_orders| total|
+-----+--------+------+
| Asha|       3|3950.0|
| Ravi|       1| 800.0|
|Meera|       2|3250.0|
|Kabir|       0|  NULL|
+-----+--------+------+

--- exists и not exists
+-----+
| name|
+-----+
| Asha|
|Meera|
| Ravi|
+-----+

+-----+
| name|
+-----+
|Kabir|
+-----+

--- lateralJoin, два последних заказа
+-----+--------+----------+------+
| name|order_id|order_date|amount|
+-----+--------+----------+------+
| Asha|     103|2026-11-03|2300.0|
| Asha|     102|2026-11-01| 450.0|
|Kabir|    NULL|      NULL|  NULL|
|Meera|     106|2026-11-03|3100.0|
|Meera|     105|2026-11-02| 150.0|
| Ravi|     104|2026-10-30| 800.0|
+-----+--------+----------+------+

rows: 6 6
only in SQL: 0 | only in DataFrame: 0
--- операторы физических планов
scalar                 Subquery -> HashAggregate
correlated scalar      SortMergeJoin(LeftOuter) -> HashAggregate
exists                 SortMergeJoin(LeftSemi)
not exists             SortMergeJoin(LeftAnti)
lateral, LIMIT 2       SortMergeJoin(LeftOuter) -> Window -> WindowGroupLimit
Значения совпали с описанием исходника. Для Kabir count вернул 0, а sum вернул NULL, как и положено в SQL. Lateral-запрос на DataFrame API и его SQL-двойник дали по шесть строк, а расхождения в обе стороны нулевые, значит множества строк одинаковы. Клиент Kabir остался в результате со значениями NULL благодаря how=»left». Планы на 4.0.4 по типам соединений совпали с тем, что исходник описывает для 4.1.1. Коррелированный скаляр дал LeftOuter, exists дал LeftSemi, отрицание exists дало LeftAnti, а lateral с limit дал Window и WindowGroupLimit. Некоррелированный скаляр остался узлом Subquery. На микроданных во всех соединениях выбран SortMergeJoin.
Теперь границы. Файл limits.py намеренно ломает код четырьмя способами и печатает класс ошибки. Пятой проверкой идёт isin() с DataFrame, который в исходнике помечен как новинка 4.1.0. Полные трассировки двух ошибок попадают в вывод как журнал драйвера, а итоговые строки с классами идут отдельно.
# limits.py · PySpark 4.0.4 · Spark 4.0.4
import re

from pyspark.sql import functions as F
from common import make_spark, make_data

spark = make_spark()
customers, orders = make_data(spark)
c, o = customers.alias("c"), orders.alias("o")


def error_class(build):
    try:
        build().collect()
        return "ok"
    except Exception as e:
        m = re.search(r"\[([A-Z_.]+)\]", str(e))
        return m.group(1) if m else type(e).__name__


print("no .outer():       ", error_class(lambda: c.select(
    o.where(F.col("o.customer_id") == F.col("c.customer_id"))
    .select(F.count("*")).scalar())))
print("df.col .outer():   ", error_class(lambda: customers.select(
    orders.where(orders.customer_id == customers.customer_id.outer())
    .select(F.count("*")).scalar())))
print("scalar, many rows: ", error_class(lambda: orders.select(
    orders.select("amount").scalar())))
print("scalar, two columns:", error_class(lambda: orders.select(
    orders.select("amount", "order_id").limit(1).scalar())))

big_spenders = orders.where("amount >= 2000").select("customer_id")
print("isin(DataFrame):   ", error_class(lambda: customers.where(
    F.col("customer_id").isin(big_spenders)).select("name")))
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:22:02 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:22:02 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:22:02 INFO SparkContext: Java version 17.0.19
26/11/04 18:22:02 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:22:02 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
{"ts": "2026-11-04 18:22:10.130", "level": "ERROR", "logger": "DataFrameQueryContextLogger", "msg": "[UNRESOLVED_COLUMN.WITH_SUGGESTION] A column, variable, or function parameter with name `c`.`customer_id` cannot be resolved. Did you mean one of the following? [`o`.`customer_id`, `o`.`order_id`, `o`.`amount`, `o`.`order_date`]. SQLSTATE: 42703", "context": {"file": "/work/limits.py", "line": "22", "fragment": "col", "errorClass": "UNRESOLVED_COLUMN.WITH_SUGGESTION"}, "exception": {"class": "Py4JJavaError", "msg": "An error occurred while calling o68.filter.\n: org.apache.spark.sql.AnalysisException: [UNRESOLVED_COLUMN.WITH_SUGGESTION] A column, variable, or function parameter with name `c`.`customer_id` cannot be resolved. Did you mean one of the following? [`o`.`customer_id`, `o`.`order_id`, `o`.`amount`, `o`.`order_date`]. SQLSTATE: 42703;\n'Filter '`=`(customer_id#4, 'c.customer_id)\n+- SubqueryAlias o\n   +- Project [order_id#3, customer_id#4, to_date(order_date#5, None, Some(Etc/UTC), true) AS order_date#7, amount#6]\n      +- LogicalRDD [order_id#3, customer_id#4, order_date#5, amount#6], false\n\n\tat org.apache.spark.sql.errors.QueryCompilationErrors$.unresolvedAttributeError(QueryCompilationErrors.scala:401)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.org$apache$spark$sql$catalyst$analysis$CheckAnalysis$$failUnresolvedAttribute(CheckAnalysis.scala:169)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7(CheckAnalysis.scala:404)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7$adapted(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1(TreeNode.scala:251)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1$adapted(TreeNode.scala:251)\n\tat scala.collection.IterableOnceOps.foreach(IterableOnce.scala:619)\n\tat scala.collection.IterableOnceOps.foreach$(IterableOnce.scala:617)\n\tat scala.collection.AbstractIterable.foreach(Iterable.scala:935)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:251)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6$adapted(CheckAnalysis.scala:402)\n\tat scala.collection.immutable.List.foreach(List.scala:334)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2$adapted(CheckAnalysis.scala:284)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0(CheckAnalysis.scala:284)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0$(CheckAnalysis.scala:255)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis0(Analyzer.scala:299)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis(CheckAnalysis.scala:244)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis$(CheckAnalysis.scala:231)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis(Analyzer.scala:299)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$resolveInFixedPoint$1(HybridAnalyzer.scala:192)\n\tat scala.runtime.java8.JFunction0$mcV$sp.apply(JFunction0$mcV$sp.scala:18)\n\tat org.apache.spark.sql.catalyst.QueryPlanningTracker$.withTracker(QueryPlanningTracker.scala:89)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.resolveInFixedPoint(HybridAnalyzer.scala:192)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$apply$1(HybridAnalyzer.scala:76)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.withTrackedAnalyzerBridgeState(HybridAnalyzer.scala:111)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.apply(HybridAnalyzer.scala:71)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.$anonfun$executeAndCheck$1(Analyzer.scala:330)\n\tat org.apache.spark.sql.catalyst.plans.logical.AnalysisHelper$.markInAnalyzer(AnalysisHelper.scala:423)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.executeAndCheck(Analyzer.scala:330)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$2(QueryExecution.scala:110)\n\tat org.apache.spark.sql.catalyst.QueryPlanningTracker.measurePhase(QueryPlanningTracker.scala:148)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$2(QueryExecution.scala:278)\n\tat org.apache.spark.sql.execution.QueryExecution$.withInternalError(QueryExecution.scala:654)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$1(QueryExecution.scala:278)\n\tat org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:804)\n\tat org.apache.spark.sql.execution.QueryExecution.executePhase(QueryExecution.scala:277)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$1(QueryExecution.scala:110)\n\tat scala.util.Try$.apply(Try.scala:217)\n\tat org.apache.spark.util.Utils$.doTryWithCallerStacktrace(Utils.scala:1378)\n\tat org.apache.spark.util.Utils$.getTryWithCallerStacktrace(Utils.scala:1439)\n\tat org.apache.spark.util.LazyTry.get(LazyTry.scala:58)\n\tat org.apache.spark.sql.execution.QueryExecution.analyzed(QueryExecution.scala:121)\n\tat org.apache.spark.sql.execution.QueryExecution.assertAnalyzed(QueryExecution.scala:80)\n\tat org.apache.spark.sql.classic.Dataset.<init>(Dataset.scala:250)\n\tat org.apache.spark.sql.classic.Dataset.<init>(Dataset.scala:262)\n\tat org.apache.spark.sql.classic.Dataset$.apply(Dataset.scala:99)\n\tat org.apache.spark.sql.classic.Dataset.withSameTypedPlan(Dataset.scala:2273)\n\tat org.apache.spark.sql.classic.Dataset.filter(Dataset.scala:926)\n\tat org.apache.spark.sql.classic.Dataset.filter(Dataset.scala:232)\n\tat java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke0(Native Method)\n\tat java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:77)\n\tat java.base/jdk.internal.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)\n\tat java.base/java.lang.reflect.Method.invoke(Method.java:569)\n\tat py4j.reflection.MethodInvoker.invoke(MethodInvoker.java:244)\n\tat py4j.reflection.ReflectionEngine.invoke(ReflectionEngine.java:374)\n\tat py4j.Gateway.invoke(Gateway.java:282)\n\tat py4j.commands.AbstractCommand.invokeMethod(AbstractCommand.java:132)\n\tat py4j.commands.CallCommand.execute(CallCommand.java:79)\n\tat py4j.ClientServerConnection.waitForCommands(ClientServerConnection.java:184)\n\tat py4j.ClientServerConnection.run(ClientServerConnection.java:108)\n\tat java.base/java.lang.Thread.run(Thread.java:840)\n\tSuppressed: org.apache.spark.util.Utils$OriginalTryStackTraceException: Full stacktrace of original doTryWithCallerStacktrace caller\n\t\tat org.apache.spark.sql.errors.QueryCompilationErrors$.unresolvedAttributeError(QueryCompilationErrors.scala:401)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.org$apache$spark$sql$catalyst$analysis$CheckAnalysis$$failUnresolvedAttribute(CheckAnalysis.scala:169)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7(CheckAnalysis.scala:404)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7$adapted(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1(TreeNode.scala:251)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1$adapted(TreeNode.scala:251)\n\t\tat scala.collection.IterableOnceOps.foreach(IterableOnce.scala:619)\n\t\tat scala.collection.IterableOnceOps.foreach$(IterableOnce.scala:617)\n\t\tat scala.collection.AbstractIterable.foreach(Iterable.scala:935)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:251)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6$adapted(CheckAnalysis.scala:402)\n\t\tat scala.collection.immutable.List.foreach(List.scala:334)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2$adapted(CheckAnalysis.scala:284)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0(CheckAnalysis.scala:284)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0$(CheckAnalysis.scala:255)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis0(Analyzer.scala:299)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis(CheckAnalysis.scala:244)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis$(CheckAnalysis.scala:231)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis(Analyzer.scala:299)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$resolveInFixedPoint$1(HybridAnalyzer.scala:192)\n\t\tat scala.runtime.java8.JFunction0$mcV$sp.apply(JFunction0$mcV$sp.scala:18)\n\t\tat org.apache.spark.sql.catalyst.QueryPlanningTracker$.withTracker(QueryPlanningTracker.scala:89)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.resolveInFixedPoint(HybridAnalyzer.scala:192)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$apply$1(HybridAnalyzer.scala:76)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.withTrackedAnalyzerBridgeState(HybridAnalyzer.scala:111)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.apply(HybridAnalyzer.scala:71)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.$anonfun$executeAndCheck$1(Analyzer.scala:330)\n\t\tat org.apache.spark.sql.catalyst.plans.logical.AnalysisHelper$.markInAnalyzer(AnalysisHelper.scala:423)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.executeAndCheck(Analyzer.scala:330)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$2(QueryExecution.scala:110)\n\t\tat org.apache.spark.sql.catalyst.QueryPlanningTracker.measurePhase(QueryPlanningTracker.scala:148)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$2(QueryExecution.scala:278)\n\t\tat org.apache.spark.sql.execution.QueryExecution$.withInternalError(QueryExecution.scala:654)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$1(QueryExecution.scala:278)\n\t\tat org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:804)\n\t\tat org.apache.spark.sql.execution.QueryExecution.executePhase(QueryExecution.scala:277)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$1(QueryExecution.scala:110)\n\t\tat scala.util.Try$.apply(Try.scala:217)\n\t\tat org.apache.spark.util.Utils$.doTryWithCallerStacktrace(Utils.scala:1378)\n\t\tat org.apache.spark.util.LazyTry.tryT$lzycompute(LazyTry.scala:46)\n\t\tat org.apache.spark.util.LazyTry.tryT(LazyTry.scala:46)\n\t\t... 21 more\n", "stacktrace": [{"class": null, "method": "deco", "file": "/opt/spark/python/lib/pyspark.zip/pyspark/errors/exceptions/captured.py", "line": "282"}, {"class": null, "method": "get_return_value", "file": "/opt/spark/python/lib/py4j-0.10.9.9-src.zip/py4j/protocol.py", "line": "327"}]}}
no .outer():        UNRESOLVED_COLUMN.WITH_SUGGESTION
df.col .outer():    MISSING_ATTRIBUTES.RESOLVED_ATTRIBUTE_APPEAR_IN_OPERATION
scalar, many rows:  SCALAR_SUBQUERY_TOO_MANY_ROWS
{"ts": "2026-11-04 18:22:13.496", "level": "ERROR", "logger": "DataFrameQueryContextLogger", "msg": "[INVALID_SUBQUERY_EXPRESSION.SCALAR_SUBQUERY_RETURN_MORE_THAN_ONE_OUTPUT_COLUMN] Invalid subquery: Scalar subquery must return only one column, but got 2. SQLSTATE: 42823", "context": {"file": "java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke0(Native Method)", "line": "", "fragment": "scalar", "errorClass": "INVALID_SUBQUERY_EXPRESSION.SCALAR_SUBQUERY_RETURN_MORE_THAN_ONE_OUTPUT_COLUMN"}, "exception": {"class": "Py4JJavaError", "msg": "An error occurred while calling o66.select.\n: org.apache.spark.sql.AnalysisException: [INVALID_SUBQUERY_EXPRESSION.SCALAR_SUBQUERY_RETURN_MORE_THAN_ONE_OUTPUT_COLUMN] Invalid subquery: Scalar subquery must return only one column, but got 2. SQLSTATE: 42823;\nProject [scalar-subquery#19 [] AS scalarsubquery()#25]\n:  +- GlobalLimit 1\n:     +- LocalLimit 1\n:        +- Project [amount#23, order_id#20]\n:           +- Project [order_id#20, customer_id#21, to_date(order_date#22, None, Some(Etc/UTC), true) AS order_date#24, amount#23]\n:              +- LogicalRDD [order_id#20, customer_id#21, order_date#22, amount#23], false\n+- Project [order_id#3, customer_id#4, to_date(order_date#5, None, Some(Etc/UTC), true) AS order_date#7, amount#6]\n   +- LogicalRDD [order_id#3, customer_id#4, order_date#5, amount#6], false\n\n\tat org.apache.spark.sql.errors.QueryCompilationErrors$.subqueryReturnMoreThanOneColumn(QueryCompilationErrors.scala:2308)\n\tat org.apache.spark.sql.catalyst.analysis.ValidateSubqueryExpression$.apply(ValidateSubqueryExpression.scala:136)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkSubqueryExpression(CheckAnalysis.scala:1049)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkSubqueryExpression$(CheckAnalysis.scala:1043)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkSubqueryExpression(Analyzer.scala:299)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7(CheckAnalysis.scala:508)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7$adapted(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1(TreeNode.scala:251)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1$adapted(TreeNode.scala:251)\n\tat scala.collection.immutable.Vector.foreach(Vector.scala:2125)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:251)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6$adapted(CheckAnalysis.scala:402)\n\tat scala.collection.immutable.List.foreach(List.scala:334)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2(CheckAnalysis.scala:402)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2$adapted(CheckAnalysis.scala:284)\n\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0(CheckAnalysis.scala:284)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0$(CheckAnalysis.scala:255)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis0(Analyzer.scala:299)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis(CheckAnalysis.scala:244)\n\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis$(CheckAnalysis.scala:231)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis(Analyzer.scala:299)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$resolveInFixedPoint$1(HybridAnalyzer.scala:192)\n\tat scala.runtime.java8.JFunction0$mcV$sp.apply(JFunction0$mcV$sp.scala:18)\n\tat org.apache.spark.sql.catalyst.QueryPlanningTracker$.withTracker(QueryPlanningTracker.scala:89)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.resolveInFixedPoint(HybridAnalyzer.scala:192)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$apply$1(HybridAnalyzer.scala:76)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.withTrackedAnalyzerBridgeState(HybridAnalyzer.scala:111)\n\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.apply(HybridAnalyzer.scala:71)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.$anonfun$executeAndCheck$1(Analyzer.scala:330)\n\tat org.apache.spark.sql.catalyst.plans.logical.AnalysisHelper$.markInAnalyzer(AnalysisHelper.scala:423)\n\tat org.apache.spark.sql.catalyst.analysis.Analyzer.executeAndCheck(Analyzer.scala:330)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$2(QueryExecution.scala:110)\n\tat org.apache.spark.sql.catalyst.QueryPlanningTracker.measurePhase(QueryPlanningTracker.scala:148)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$2(QueryExecution.scala:278)\n\tat org.apache.spark.sql.execution.QueryExecution$.withInternalError(QueryExecution.scala:654)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$1(QueryExecution.scala:278)\n\tat org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:804)\n\tat org.apache.spark.sql.execution.QueryExecution.executePhase(QueryExecution.scala:277)\n\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$1(QueryExecution.scala:110)\n\tat scala.util.Try$.apply(Try.scala:217)\n\tat org.apache.spark.util.Utils$.doTryWithCallerStacktrace(Utils.scala:1378)\n\tat org.apache.spark.util.Utils$.getTryWithCallerStacktrace(Utils.scala:1439)\n\tat org.apache.spark.util.LazyTry.get(LazyTry.scala:58)\n\tat org.apache.spark.sql.execution.QueryExecution.analyzed(QueryExecution.scala:121)\n\tat org.apache.spark.sql.execution.QueryExecution.assertAnalyzed(QueryExecution.scala:80)\n\tat org.apache.spark.sql.classic.Dataset$.$anonfun$ofRows$1(Dataset.scala:115)\n\tat org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:804)\n\tat org.apache.spark.sql.classic.Dataset$.ofRows(Dataset.scala:113)\n\tat org.apache.spark.sql.classic.Dataset.withPlan(Dataset.scala:2263)\n\tat org.apache.spark.sql.classic.Dataset.select(Dataset.scala:894)\n\tat org.apache.spark.sql.classic.Dataset.select(Dataset.scala:232)\n\tat java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke0(Native Method)\n\tat java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:77)\n\tat java.base/jdk.internal.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)\n\tat java.base/java.lang.reflect.Method.invoke(Method.java:569)\n\tat py4j.reflection.MethodInvoker.invoke(MethodInvoker.java:244)\n\tat py4j.reflection.ReflectionEngine.invoke(ReflectionEngine.java:374)\n\tat py4j.Gateway.invoke(Gateway.java:282)\n\tat py4j.commands.AbstractCommand.invokeMethod(AbstractCommand.java:132)\n\tat py4j.commands.CallCommand.execute(CallCommand.java:79)\n\tat py4j.ClientServerConnection.waitForCommands(ClientServerConnection.java:184)\n\tat py4j.ClientServerConnection.run(ClientServerConnection.java:108)\n\tat java.base/java.lang.Thread.run(Thread.java:840)\n\tSuppressed: org.apache.spark.util.Utils$OriginalTryStackTraceException: Full stacktrace of original doTryWithCallerStacktrace caller\n\t\tat org.apache.spark.sql.errors.QueryCompilationErrors$.subqueryReturnMoreThanOneColumn(QueryCompilationErrors.scala:2308)\n\t\tat org.apache.spark.sql.catalyst.analysis.ValidateSubqueryExpression$.apply(ValidateSubqueryExpression.scala:136)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkSubqueryExpression(CheckAnalysis.scala:1049)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkSubqueryExpression$(CheckAnalysis.scala:1043)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkSubqueryExpression(Analyzer.scala:299)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7(CheckAnalysis.scala:508)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$7$adapted(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1(TreeNode.scala:251)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.$anonfun$foreachUp$1$adapted(TreeNode.scala:251)\n\t\tat scala.collection.immutable.Vector.foreach(Vector.scala:2125)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:251)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$6$adapted(CheckAnalysis.scala:402)\n\t\tat scala.collection.immutable.List.foreach(List.scala:334)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2(CheckAnalysis.scala:402)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.$anonfun$checkAnalysis0$2$adapted(CheckAnalysis.scala:284)\n\t\tat org.apache.spark.sql.catalyst.trees.TreeNode.foreachUp(TreeNode.scala:252)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0(CheckAnalysis.scala:284)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis0$(CheckAnalysis.scala:255)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis0(Analyzer.scala:299)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis(CheckAnalysis.scala:244)\n\t\tat org.apache.spark.sql.catalyst.analysis.CheckAnalysis.checkAnalysis$(CheckAnalysis.scala:231)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.checkAnalysis(Analyzer.scala:299)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$resolveInFixedPoint$1(HybridAnalyzer.scala:192)\n\t\tat scala.runtime.java8.JFunction0$mcV$sp.apply(JFunction0$mcV$sp.scala:18)\n\t\tat org.apache.spark.sql.catalyst.QueryPlanningTracker$.withTracker(QueryPlanningTracker.scala:89)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.resolveInFixedPoint(HybridAnalyzer.scala:192)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.$anonfun$apply$1(HybridAnalyzer.scala:76)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.withTrackedAnalyzerBridgeState(HybridAnalyzer.scala:111)\n\t\tat org.apache.spark.sql.catalyst.analysis.resolver.HybridAnalyzer.apply(HybridAnalyzer.scala:71)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.$anonfun$executeAndCheck$1(Analyzer.scala:330)\n\t\tat org.apache.spark.sql.catalyst.plans.logical.AnalysisHelper$.markInAnalyzer(AnalysisHelper.scala:423)\n\t\tat org.apache.spark.sql.catalyst.analysis.Analyzer.executeAndCheck(Analyzer.scala:330)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$2(QueryExecution.scala:110)\n\t\tat org.apache.spark.sql.catalyst.QueryPlanningTracker.measurePhase(QueryPlanningTracker.scala:148)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$2(QueryExecution.scala:278)\n\t\tat org.apache.spark.sql.execution.QueryExecution$.withInternalError(QueryExecution.scala:654)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$executePhase$1(QueryExecution.scala:278)\n\t\tat org.apache.spark.sql.SparkSession.withActive(SparkSession.scala:804)\n\t\tat org.apache.spark.sql.execution.QueryExecution.executePhase(QueryExecution.scala:277)\n\t\tat org.apache.spark.sql.execution.QueryExecution.$anonfun$lazyAnalyzed$1(QueryExecution.scala:110)\n\t\tat scala.util.Try$.apply(Try.scala:217)\n\t\tat org.apache.spark.util.Utils$.doTryWithCallerStacktrace(Utils.scala:1378)\n\t\tat org.apache.spark.util.LazyTry.tryT$lzycompute(LazyTry.scala:46)\n\t\tat org.apache.spark.util.LazyTry.tryT(LazyTry.scala:46)\n\t\t... 21 more\n", "stacktrace": [{"class": null, "method": "deco", "file": "/opt/spark/python/lib/pyspark.zip/pyspark/errors/exceptions/captured.py", "line": "282"}, {"class": null, "method": "get_return_value", "file": "/opt/spark/python/lib/py4j-0.10.9.9-src.zip/py4j/protocol.py", "line": "327"}]}}
scalar, two columns: INVALID_SUBQUERY_EXPRESSION.SCALAR_SUBQUERY_RETURN_MORE_THAN_ONE_OUTPUT_COLUMN
isin(DataFrame):    ATTRIBUTE_NOT_SUPPORTED
Четыре класса ошибок на 4.0.4 соответствуют правилам, которые описаны выше. Без outer() Spark не находит c.customer_id внутри подзапроса и предлагает колонки таблицы o. Вызов outer() на атрибуте DataFrame дал на стенде MISSING_ATTRIBUTES.RESOLVED_ATTRIBUTE_APPEAR_IN_OPERATION. Причину мы не исследовали, а в наших примерах везде стоит F.col с алиасом, и именно эта форма отработала. Скаляр с несколькими строками завершается ошибкой SCALAR_SUBQUERY_TOO_MANY_ROWS, но на каком этапе, этот прогон не показывает. Скаляр с двумя колонками падает с INVALID_SUBQUERY_EXPRESSION.SCALAR_SUBQUERY_RETURN_MORE_THAN_ONE_OUTPUT_COLUMN, и по трассировке видно, что это ошибка анализа.
Последняя строка вывода показывает, что на 4.0.4 isin(DataFrame) завершается ошибкой ATTRIBUTE_NOT_SUPPORTED. Это согласуется с исходником, который относит такую возможность к 4.1.0. Сама версия 4.1.0 взята из исходника, прогоном на 4.1 мы её не подтверждали, поэтому подтверждено только поведение 4.0.4. На 4.0 можно записать похожую задачу через exists() с коррелированным условием, как в третьем задании. На наших данных результат совпал с ожидаемым, а эквивалентность двух форм в общем случае прогон не доказывает.
Наконец, файл compare.py решает одну задачу пятью способами. Эталоном служит SQL-строка, остальные варианты сверяются с ней через exceptAll в обе стороны. Затем печатаются планы, а в конце подзапрос и вариант с groupBy проверяются на 300 тысячах строк, чтобы увидеть, остаётся ли форма плана прежней при росте данных.
# compare.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import Window, functions as F
from common import make_spark, make_data, plan_ops

spark = make_spark()
customers, orders = make_data(spark)
orders.createOrReplaceTempView("orders")


def sql_way(df):
    return spark.sql("""
        SELECT o.order_id, o.customer_id, o.amount
        FROM orders o
        WHERE o.amount > (SELECT AVG(o2.amount) FROM orders o2
                          WHERE o2.customer_id = o.customer_id)
    """)


def subquery_way(df):
    o, o2 = df.alias("o"), df.alias("o2")
    own_avg = (o2.where(F.col("o2.customer_id") == F.col("o.customer_id").outer())
               .select(F.avg("amount")).scalar())
    return (o.where(F.col("o.amount") > own_avg)
            .select("o.order_id", "o.customer_id", "o.amount"))


def groupby_way(df):
    avgs = df.groupBy("customer_id").agg(F.avg("amount").alias("avg_amount"))
    return (df.join(avgs, "customer_id")
            .where(F.col("amount") > F.col("avg_amount"))
            .select("order_id", "customer_id", "amount"))


def window_way(df):
    w = Window.partitionBy("customer_id")
    return (df.withColumn("avg_amount", F.avg("amount").over(w))
            .where(F.col("amount") > F.col("avg_amount"))
            .select("order_id", "customer_id", "amount"))


def collect_way(df):
    rows = df.groupBy("customer_id").agg(F.avg("amount").alias("a")).collect()
    kv = []
    for r in rows:
        kv += [F.lit(r["customer_id"]), F.lit(r["a"])]
    m = F.create_map(*kv)
    return (df.where(F.col("amount") > m[F.col("customer_id")])
            .select("order_id", "customer_id", "amount"))


ways = {"sql": sql_way, "subquery": subquery_way, "groupby": groupby_way,
        "window": window_way, "collect": collect_way}
ref = sql_way(orders)
print("--- сверка с SQL-строкой")
for name, build in ways.items():
    df = build(orders)
    print(f"{name:<10} rows={df.count()} extra={df.exceptAll(ref).count()} "
          f"missing={ref.exceptAll(df).count()}")

print("--- планы на малых данных")
for name, build in ways.items():
    plan_ops(name, build(orders))

print("--- планы на 300000 строк")
big = spark.range(300000).select(
    (F.col("id") % 1000).cast("int").alias("customer_id"),
    F.col("id").cast("int").alias("order_id"),
    (F.col("id") % 97).cast("double").alias("amount"))
plan_ops("subquery, big", subquery_way(big))
plan_ops("groupby, big", groupby_way(big))
print("rows big:", subquery_way(big).count(), groupby_way(big).count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:22:17 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:22:17 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:22:17 INFO SparkContext: Java version 17.0.19
26/11/04 18:22:17 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:22:17 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
--- сверка с SQL-строкой
sql        rows=2 extra=0 missing=0
subquery   rows=2 extra=0 missing=0
groupby    rows=2 extra=0 missing=0
window     rows=2 extra=0 missing=0
collect    rows=2 extra=0 missing=0
--- планы на малых данных
sql                    SortMergeJoin(Inner) -> HashAggregate
subquery               SortMergeJoin(Inner) -> HashAggregate
groupby                SortMergeJoin(Inner) -> HashAggregate
window                 Window
collect                (нет соединений и агрегатов)
--- планы на 300000 строк
subquery, big          BroadcastHashJoin(Inner) -> HashAggregate
groupby, big           BroadcastHashJoin(Inner) -> HashAggregate
rows big: 149991 149991
Что показал прогон. Все пять способов вернули по две строки без лишних и пропущенных относительно SQL-эталона, то есть на этих данных результаты совпали. Планы SQL-строки, подзапроса и groupBy с join одинаковы, а именно SortMergeJoin с типом Inner и затем HashAggregate. Коррелированный скаляр в where превратился в Inner, а не в LeftOuter, как в select. Вероятно, оптимизатор свёл соединение к Inner, потому что строки без пары в фильтре всё равно отбрасываются, но логический план мы не смотрели, и прогон показывает только итоговый тип. Оконный вариант обошёлся без соединения, одним узлом Window. В варианте с collect среднее посчитано отдельным заданием до построения запроса, поэтому в его плане нет ни соединений, ни агрегатов.
На 300 тысячах строк тип соединения остался Inner у подзапроса и у groupBy, но алгоритм сменился с SortMergeJoin на BroadcastHashJoin. Обе записи вернули по 149991 строке. Это один набор данных и один запрос, поэтому вывод узкий. На этих данных тип соединения не изменился, а алгоритм оптимизатор выбрал заново, и по микроданным его предсказать не получилось. Чего прогон не доказывает. Он не измеряет время и не заменяет профилирование на кластере, а локальный режим на одном хосте показывает только форму плана.
Задания
Все решения используют общий модуль common.py и запускаются тем же spark-submit, что и основной пример.
Задание 1. Выведите клиентов, у которых сумма заказов выше средней суммы по всем клиентам, через scalar() и сверьте результат с вариантом groupBy плюс crossJoin через exceptAll.
Решение
# task1.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F
from common import make_spark, make_data

spark = make_spark()
customers, orders = make_data(spark)

totals = orders.groupBy("customer_id").agg(F.sum("amount").alias("total"))
avg_total = totals.select(F.avg("total")).scalar()

with_scalar = (customers.join(totals, "customer_id")
               .where(F.col("total") > avg_total)
               .select("name", "total"))

with_join = (customers.join(totals, "customer_id")
             .crossJoin(totals.agg(F.avg("total").alias("avg_total")))
             .where(F.col("total") > F.col("avg_total"))
             .select("name", "total"))

with_scalar.orderBy("name").show()
print("only scalar:", with_scalar.exceptAll(with_join).count(),
      "| only join:", with_join.exceptAll(with_scalar).count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:22:51 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:22:51 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:22:51 INFO SparkContext: Java version 17.0.19
26/11/04 18:22:51 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:22:51 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
+-----+------+
| name| total|
+-----+------+
| Asha|3950.0|
|Meera|3250.0|
+-----+------+

only scalar: 0 | only join: 0
Задание 2. Для каждого клиента получите заказ с максимальной суммой и его дату через lateralJoin() с limit(1), сохраните клиентов без заказов (how=»left») и сверьте результат с оконным вариантом на row_number.
Решение
# task2.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import Window, functions as F
from common import make_spark, make_data

spark = make_spark()
customers, orders = make_data(spark)

best = (orders.alias("o")
        .where(F.col("o.customer_id") == F.col("c.customer_id").outer())
        .orderBy(F.col("o.amount").desc())
        .limit(1)
        .select("o.order_id", "o.order_date", "o.amount"))
lateral = (customers.alias("c").lateralJoin(best, how="left")
           .select("name", "order_id", "order_date", "amount"))

w = Window.partitionBy("customer_id").orderBy(F.col("amount").desc())
windowed = (customers.join(orders.drop("order_date").join(
                orders.select("order_id", "order_date"), "order_id"),
                "customer_id", "left")
            .withColumn("rn", F.row_number().over(w))
            .where(F.col("rn") == 1)
            .select("name", "order_id", "order_date", "amount"))

lateral.orderBy("name").show()
print("only lateral:", lateral.exceptAll(windowed).count(),
      "| only window:", windowed.exceptAll(lateral).count())
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:23:10 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:23:10 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:23:10 INFO SparkContext: Java version 17.0.19
26/11/04 18:23:10 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:23:10 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
+-----+--------+----------+------+
| name|order_id|order_date|amount|
+-----+--------+----------+------+
| Asha|     103|2026-11-03|2300.0|
|Kabir|    NULL|      NULL|  NULL|
|Meera|     106|2026-11-03|3100.0|
| Ravi|     104|2026-10-30| 800.0|
+-----+--------+----------+------+

only lateral: 0 | only window: 0
Задание 3. Запишите задачу «клиенты с заказом от 2000», которую в 4.1 решает isin(DataFrame), через exists() с коррелированным условием, чтобы код работал на Spark 4.0, и покажите по плану, что получилось полусоединение LeftSemi.
Решение
# task3.py · PySpark 4.0.4 · Spark 4.0.4
from pyspark.sql import functions as F
from common import make_spark, make_data, plan_text

spark = make_spark()
customers, orders = make_data(spark)
c = customers.alias("c")

big = (orders.alias("o")
       .where((F.col("o.customer_id") == F.col("c.customer_id").outer())
              & (F.col("o.amount") >= 2000)))
result = c.where(big.exists()).select("name")

result.orderBy("name").show()
print("LeftSemi в плане:", "LeftSemi" in plan_text(result))
WARNING: Using incubator modules: jdk.incubator.vector
Using Spark's default log4j profile: org/apache/spark/log4j2-defaults.properties
26/11/04 18:23:31 INFO SparkContext: Running Spark version 4.0.4
26/11/04 18:23:31 INFO SparkContext: OS info Linux, 7.0.0-1014-aws, amd64
26/11/04 18:23:31 INFO SparkContext: Java version 17.0.19
26/11/04 18:23:31 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting Spark log level to "WARN".
26/11/04 18:23:31 WARN SparkConf: Note that spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in standalone/kubernetes and LOCAL_DIRS in YARN).
+-----+
| name|
+-----+
| Asha|
|Meera|
+-----+

LeftSemi в плане: True
Приёмы из этой статьи, от планов запросов и соединений до подзапросов и окон, подробно разбираются на курсе Анализ данных с Spark Streaming, Spark SQL, MLlib и GraphX, где есть практика на таких же стендах.